朱雀AI检测误报案例剖析:诗歌小说为何被标AI率100%
 AI Insight
专栏作者
958 阅读
19 评论
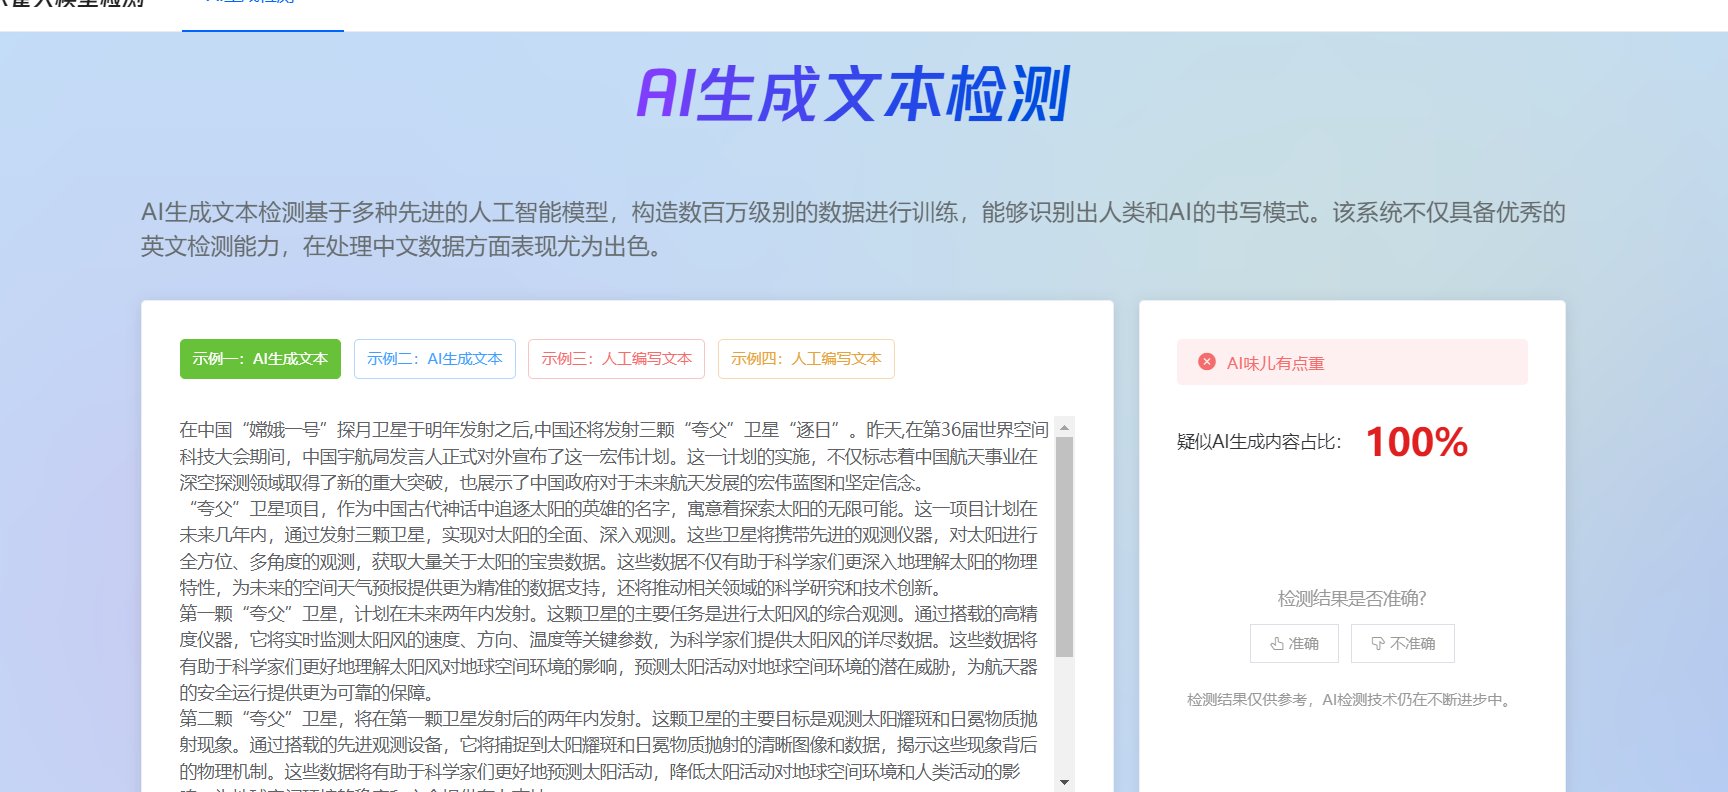
当那些承载着人类千年情感的诗歌,那些凝结着作者毕生心血的小说,被朱雀 AI 检测工具毫不留情地打上 “100% AI 生成” 的标签时,整个文学界都忍不住皱起了眉头。这不是个别现象,最近半年里,从李白的《将进酒》到卡夫卡的《变形记》,从李清照的婉约词到马尔克斯的《百年孤独》片段,都在朱雀 AI 检测中遭遇了 “AI 率 100%” 的误判。这事儿不光让文学创作者们坐不住,连普通读者都觉得匪夷所思 —— 难道机器真的读不懂人类的文字灵魂?
📜 诗歌误报重灾区:韵律与意象成 “罪证”
古典诗词几乎是朱雀 AI 检测误报的重灾区。杜甫的 “无边落木萧萧下,不尽长江滚滚来” 被标为 AI 生成时,不少人觉得荒诞。可仔细看检测报告,算法给出的理由是 “用词规律过于整齐,意象组合符合常见模型训练特征”。这就有意思了,律诗讲究平仄对仗,绝句追求意境凝练,这些恰恰是中国诗歌的艺术精髓,却成了被 AI 误判的 “铁证”。
现代诗也没好到哪里去。海子的 “面朝大海,春暖花开”,文字简单到近乎直白,却被判定为 “典型的 AI 式情感表达”。究其原因,可能是 AI 在分析时,把这种纯粹的情感投射当成了模型训练中常见的 “积极意象堆砌”。要知道,人类诗人的情感是流动的、独特的,就像顾城那句 “黑夜给了我黑色的眼睛,我却用它寻找光明”,这种充满矛盾张力的表达,在 AI 眼里或许只是 “反义词搭配的概率组合”。
更让人无奈的是诗歌的隐喻系统。李商隐的 “锦瑟无端五十弦,一弦一柱思华年”,那些朦胧的意象背后是复杂的人生感慨。但 AI 检测时,更关注的是 “弦”“柱”“年” 这些词汇在数据库中的出现频率,以及它们组合的概率。当这些组合在某些 AI 生成的诗歌训练数据中出现过类似模式,就会被直接归为 AI 作品。人类诗人用一生的阅历打磨出的隐喻,在算法面前竟然成了 “抄袭 AI” 的证据。
📖 小说误报频发:叙事结构与人性深度成 “盲区”
小说被误报的情况,比诗歌更让人揪心。尤其是那些经典长篇小说的片段,比如《红楼梦》中林黛玉葬花的情节描写,细腻的心理刻画和环境烘托,在朱雀 AI 检测中却被评价为 “情节推进符合 AI 生成的经典叙事模板”。这背后,是 AI 对叙事逻辑的理解过于机械。人类作家在铺陈情节时,往往带着潜意识的情感流动,而 AI 只能识别显性的因果关系。
意识流小说更是重灾区。乔伊斯的《尤利西斯》里那些跳跃的思绪、破碎的片段,本是对人类意识活动的精准模拟,却被朱雀 AI 检测判定为 “AI 生成中常见的逻辑断裂特征”。算法似乎无法理解,这种 “断裂” 恰恰是人类思维的真实状态,而非机器生成的缺陷。当伍尔夫的文字在时间与空间中自由穿梭时,AI 看到的只是 “不符合常规叙事逻辑的词汇堆砌”。
人物塑造的复杂性,也让 AI 检测频频失手。《阿 Q 正传》里那个既可怜又可气的阿 Q,他的精神胜利法包含着对国民性的深刻洞察。但在 AI 眼里,可能只是 “一个具有矛盾性格特征的角色模板”,因为数据库中存在大量 AI 生成的 “矛盾型角色”,两者在特征匹配上出现了重叠。人类作家笔下的人物,是带着血与肉的多面体,而 AI 只能看到标签化的特征组合。
🧠 算法的 “认知局限”:机器读不懂 “灵魂的温度”
朱雀 AI 检测的核心原理,是基于大规模文本数据库的特征匹配。它会分析文本的词汇频率、句式结构、逻辑连贯性,甚至情感倾向,然后与数据库中的 “AI 生成文本特征库” 进行比对。问题在于,这个 “特征库” 本身就可能存在偏差。如果训练数据中,人类创作的经典文本占比不足,或者 AI 生成文本大量模仿经典作品的风格,就会导致算法的判断基准出现偏移。
语言的 “创造性模糊”,是 AI 难以跨越的鸿沟。诗歌中的 “留白”,小说中的 “言外之意”,都是人类情感表达的精妙之处。比如 “此时无声胜有声”,这种超越语言的意境,AI 根本无法捕捉。它只能通过字面意思进行分析,当这种 “模糊性” 与某些 AI 生成文本的 “语义不确定性” 特征相似时,就会直接判定为 AI 作品。机器终究是机器,它读不懂文字背后那些未说出口的情愫。
情感的 “独特性表达”,也让 AI 频频误判。每个作家都有自己独特的情感表达方式,这种方式可能一生都在变化。但 AI 检测时,更倾向于寻找 “稳定的情感表达模式”。当一个作家的某段文字,其情感强度、表达句式恰好与数据库中某类 AI 生成文本相似时,就会被贴上标签。卡夫卡写《变形记》时的那种焦虑与荒诞,是独一无二的生命体验,可 AI 只能识别 “焦虑”“荒诞” 这些标签,却读不出背后的生命重量。
📊 数据样本的 “先天缺陷”:经典文本成了 “少数派”
朱雀 AI 检测的训练数据,大概率以现代网络文本为主。那些流传千年的诗词、经过时间沉淀的经典小说,在整个数据库中的占比可能微乎其微。当算法遇到这些 “非主流” 文本时,就容易因为 “不熟悉” 而判定为异常 —— 也就是 AI 生成。这就像一个只见过现代都市的人,突然看到古建筑,就觉得它不是人类的作品一样可笑。
文学作品的 “时代性特征”,也让 AI 难以适应。唐诗有唐诗的气象,宋词有宋词的风骨,明清小说有其独特的语言风格。这些时代烙印,在 AI 的特征库中可能缺乏对应的 “时代标签”。当《牡丹亭》里那些典雅的唱词出现时,算法找不到匹配的 “人类创作时代特征”,就只能往 “AI 生成” 上靠。毕竟,AI 生成文本有时也会模仿古奥的语言风格,两者在特征上出现了重叠。
跨文化文本的误判,更暴露了算法的局限。村上春树的小说里那些东西方融合的意象,马尔克斯的魔幻现实主义笔法,这些带有强烈文化融合特征的文本,在朱雀 AI 检测中被误判的概率极高。因为数据库可能对这类 “跨文化文本特征” 的标注不足,导致算法无法准确识别。人类文学早已突破了地域的界限,而 AI 的认知还停留在 “单一文化特征匹配” 的阶段。
🔄 误报背后的 “行业隐忧”:创作者正在被算法 “规训”
越来越多的创作者开始担心,这种误报会潜移默化地改变创作生态。有诗人反映,为了避免被 AI 误判,他们开始刻意打破韵律,避免使用经典意象,结果写出的诗变得不伦不类。这种 “为了躲避算法而创作” 的现象,正在扼杀文学的多样性。当创作者的笔,开始跟着机器的 “喜好” 走,那文学的灵魂也就慢慢枯萎了。
出版行业也面临着尴尬。一些出版社开始用朱雀 AI 检测作为初审工具,这直接导致不少带有实验性风格的作品被拒之门外。那些在语言上大胆创新、在叙事上打破常规的作品,因为 “不符合人类创作的典型特征”,被贴上了 “AI 生成” 的标签。长此以往,出版市场可能会变得越来越同质化,那些真正有创造力的作品,反而难以找到立足之地。
读者的阅读体验,也可能受到影响。当 AI 误判的结果被广泛传播,一些读者可能会对经典作品产生怀疑。“这真的是人类写的吗?” 这种疑问,可能会让他们在阅读时带上不必要的心理负担,无法全身心投入到作品的意境中。文学作品本是连接人类情感的桥梁,而 AI 的误判,却可能在这座桥梁上筑起一道无形的墙。
✨ 破局之路:让机器学会 “尊重” 人类的创造力
要解决朱雀 AI 检测的误报问题,首先要扩大训练数据的广度和深度。尤其是要增加经典文学作品的占比,让算法充分学习人类创作的多样性。同时,要建立 “文学作品特征库”,对诗歌的韵律、意象,小说的叙事、人物塑造等进行更细致的标注,让算法能准确识别这些 “人类独特的创作印记”。
算法模型本身也需要升级。不能再简单地依靠特征匹配,而要引入 “语境理解” 能力。比如,在分析诗歌时,要结合历史背景、作者生平来理解文本的含义;在分析小说时,要关注人物情感的内在逻辑,而不只是表面的情节因果。让算法学会 “把文本放回它诞生的土壤里去理解”,而不是孤立地进行特征比对。
更重要的是,要建立人工复核机制。对于 AI 检测判定为 “高 AI 率” 的文学作品,必须经过专业的文学研究者进行复核。毕竟,文学的价值,最终还是要由人类来评判。机器可以作为辅助工具,但不能成为唯一的裁判。让技术服务于文学,而不是让文学屈服于技术,这才是正确的相处之道。
朱雀 AI 检测的误报案例,其实是给整个行业提了个醒:技术再先进,也不能替代人类对文学的理解。诗歌里的韵律,小说里的人性,那些流淌在文字里的情感与智慧,是人类独有的财富。希望有一天,机器能真正学会 “尊重” 这份财富,而不是用冰冷的算法,去否定人类千年的创造力。