AI生成内容检测的原理是什么?了解机制,才能有效规避
 AI Insight
专栏作者
1.5k 阅读
76 评论
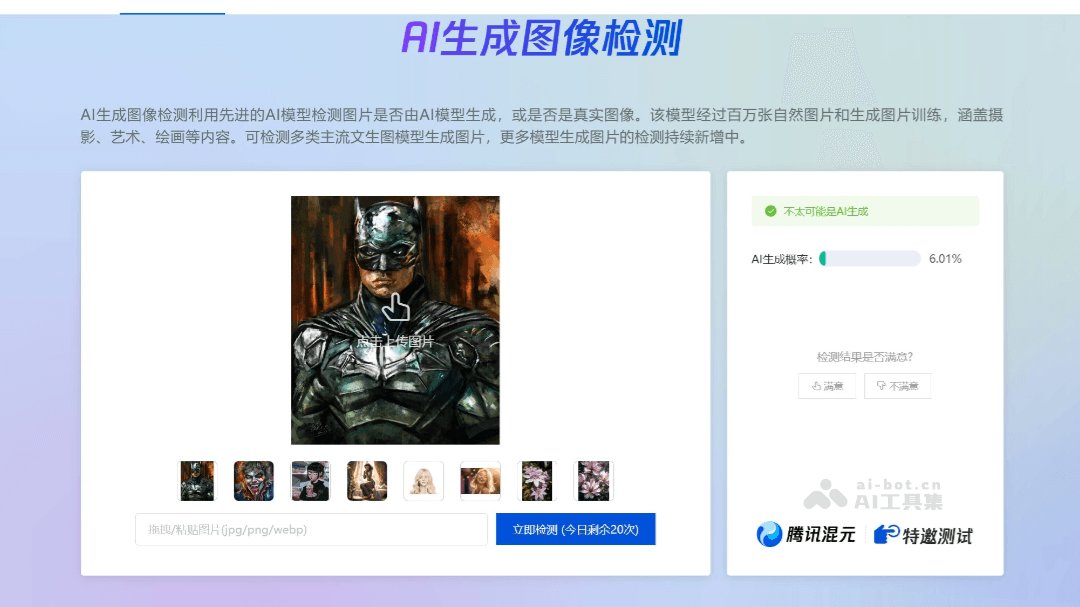
AI 生成内容检测这事儿,现在越来越受关注。不管是自媒体创作者,还是学生写论文,都怕自己用 AI 生成的内容被揪出来。可你知道这些检测工具到底是怎么干活的吗?不把原理搞明白,想规避检测纯属瞎猫碰死耗子。今天就来好好扒一扒,让你心里有个数。
📝文本特征分析:AI 的 “说话习惯” 藏不住
AI 写东西,跟人比,在文本特征上有不少不一样的地方。这些不一样,就是检测工具抓把柄的关键。
先看词汇选择。人说话写东西,词汇可能更灵活,有时候还会用点方言、俚语,甚至生僻词。但 AI 呢,它是基于大量数据训练出来的,所以更倾向于用那些高频、通用的词汇,不太会用太偏的表达。比如写一篇关于 “高兴” 的文章,人可能会用 “欣喜若狂”“乐不可支”“美滋滋”,而 AI 可能翻来覆去就是 “开心”“高兴”“快乐” 这几个词。检测工具会统计文本里词汇的出现频率和独特性,一旦发现词汇多样性低,高频词反复出现,就会打个问号。
再看句式结构。人写东西,句式长短交错,有时候还会有不符合常规语法但能看懂的句子,显得更自然。AI 生成的句子呢,往往更 “标准”,结构相对固定,长句可能会很复杂但逻辑严谨,短句又显得有点生硬。就像写一段话描述风景,人可能会写 “天上飘着云,风一吹,动了,挺好看”,AI 可能就会写 “天空中漂浮着白云,当风吹过时,它们缓缓移动,呈现出美丽的景象”。检测工具能捕捉到这种句式的规律性,从而判断内容是否由 AI 生成。
还有标点符号的使用。人在使用标点时,可能会根据语气和表达需要,有一些灵活的用法,比如多个逗号连用,或者感叹号、问号用得比较随性。AI 对标的点符号使用则更遵循规则,很少有 “出格” 的情况。检测工具会分析标点的分布和使用习惯,如果发现太 “规矩”,也可能怀疑是 AI 的手笔。
🔗语义连贯性分析:逻辑断层是 AI 的软肋
语义连贯性是判断内容是否为人创作的重要依据。人在思考和表达时,思路是连贯的,前后内容的逻辑关系也比较紧密。即使偶尔有跳跃,也能从上下文找到合理的解释。
AI 生成内容在语义连贯上就容易出问题。有时候,前一句说的是 A 话题,下一句突然跳到 B 话题,中间没有过渡,逻辑上衔接不上。比如写一篇关于学习方法的文章,前面在说如何记笔记,突然就转到了天气怎么样,这就很可能是 AI 生成的。检测工具会通过分析句子之间的语义关联度,看是否存在这种逻辑断层。
另外,AI 对上下文的呼应也可能做得不够好。人会在后面的内容里呼应前面提到的观点、人物或事件,让整篇文章形成一个有机的整体。但 AI 可能会 “忘记” 前面说过的话,后面的内容和前面没有关联。比如前面提到 “小明喜欢打篮球”,后面却写 “小明从不参加任何体育活动”,这就是明显的呼应失误。检测工具能捕捉到这种前后矛盾的地方,以此作为判断依据。
还有就是主题一致性。人写文章,一般会围绕一个核心主题展开,即使有分支内容,也不会偏离太远。AI 可能在写作过程中,不知不觉就偏离了主题,写着写着就跑到别的地方去了。比如本来是写美食的,结果大篇幅地写起了旅游景点,检测工具发现主题漂移严重,就会认为有 AI 生成的可能。
📊训练数据比对:AI 逃不过 “出身” 的痕迹
AI 生成内容的 “出身” 就是它的训练数据,这也是检测工具的一个重要突破口。AI 模型在训练时,会吸收海量的文本数据,这些数据就像它的 “记忆”。当它生成内容时,难免会带上这些训练数据的痕迹。
检测工具会把待检测的文本和已知的 AI 训练数据进行比对。如果文本中有大段内容和训练数据里的某部分高度相似,甚至几乎一样,那很可能就是 AI 生成的。因为人在创作时,虽然也会借鉴,但很少会原封不动地照搬,而 AI 可能会在生成过程中 “复述” 训练数据里的内容。
而且,不同的 AI 模型,训练数据的来源和范围不同,生成的内容也会带有各自的 “风格”。就像不同的作家有不同的写作风格一样,不同的 AI 模型也有其独特的 “文风”。检测工具会对不同 AI 模型的风格进行分析和总结,当检测到某篇文本符合某个 AI 模型的风格时,就会给出相应的判断。
还有一种情况,就是 AI 生成的内容会包含一些训练数据中的 “错误信息”。如果训练数据里有错误,AI 在学习时可能会把这些错误也吸收进去,生成内容时就会再现这些错误。人在创作时,会有自己的判断,会修正错误,而 AI 可能做不到。检测工具一旦发现文本里有这些特定的错误信息,就会联想到对应的训练数据,从而怀疑是 AI 生成的。
📈统计模式识别:数字背后的秘密
文本中的一些统计模式,也能成为检测 AI 生成内容的线索。比如句子长度的分布,人写的文章,句子有长有短,长度分布比较随机。而 AI 生成的句子,长度可能更集中在某个范围内,分布相对规律。检测工具会统计句子的长度,绘制分布曲线,通过曲线的形状来判断是否为 AI 生成。
段落长度也有类似的情况。人划分段落,会根据内容的逻辑和表达的需要,段落长度不一。AI 划分段落可能更机械,长度相对平均。检测工具分析段落长度的变化情况,能发现其中的差异。
还有词频分布,除了前面说的词汇选择,不同词性的词出现的频率也有讲究。比如动词、名词、形容词的比例,人写的内容和 AI 生成的内容可能不一样。检测工具会计算这些词性的出现频率,看是否符合 AI 生成的特征。
🌐跨语言特性:多语言环境下的 AI 马脚
在跨语言的内容生成中,AI 也容易露出马脚。现在很多 AI 模型支持多语言生成,但在不同语言转换和表达上,会有一些独特的特征。
比如在翻译生成内容时,AI 可能会出现 “直译” 的痕迹,把一种语言的表达习惯直接套用到另一种语言上,显得不自然。人在翻译或用第二语言写作时,会更注重目标语言的表达习惯,让内容更通顺。检测工具能识别这种不自然的跨语言表达,判断是否为 AI 生成。
另外,AI 在处理多语言中的歧义现象时,可能会出现错误。不同语言中有些词语有多种含义,人能根据上下文准确理解和使用,而 AI 可能会选错意思。比如一个词在中文里有 A 和 B 两个意思,AI 可能在不恰当的语境下用了 A 意思,而人会用 B 意思。检测工具发现这种歧义处理错误,就会怀疑是 AI 生成的。
🛡️了解机制,有效规避 AI 检测
知道了 AI 生成内容检测的原理,我们就可以有针对性地规避检测了。
针对文本特征,我们可以在 AI 生成内容后,主动替换一些高频词汇,增加词汇的多样性。多使用一些俚语、方言或生僻词,但要注意用得恰当。同时,调整句式结构,让长短句结合更自然,模仿人的写作习惯,适当加入一些不那么 “标准” 但通顺的句子。标点符号也可以灵活使用,不用那么拘谨。
对于语义连贯性问题,在生成内容后,要仔细检查逻辑是否连贯,有没有断层和前后矛盾的地方。可以在写作过程中,时不时回顾前面的内容,确保后面的内容能和前面呼应,保持主题的一致性。如果发现有偏离主题的部分,及时修改或删除。
面对训练数据比对,我们要避免让 AI 生成的内容和已知训练数据高度相似。可以在 AI 生成的基础上进行大幅度的修改和重组,加入自己的观点、案例和经历,让内容更具独特性。同时,要对内容进行事实核查,修正可能存在的错误信息。
针对统计模式,在编辑 AI 生成的内容时,刻意调整句子和段落的长度,让其分布更随机。改变词频分布,合理增加或减少不同词性词语的使用。
在跨语言内容生成方面,如果涉及翻译或用第二语言写作,要多参考目标语言的表达习惯,对 AI 生成的内容进行润色,避免直译的痕迹。仔细检查歧义处理是否正确,确保表达准确自然。
【该文章由diwuai.com
第五 ai 创作,第五 AI - 高质量公众号、头条号等自媒体文章创作平台 | 降 AI 味 + AI 检测 + 全网热搜爆文库🔗立即免费注册 开始体验工具箱 - 朱雀 AI 味降低到 0%- 降 AI 去 AI 味】