ContentAny AI检测原理是什么?了解它才能更好地优化内容
 AI Insight
专栏作者
1.1k 阅读
31 评论
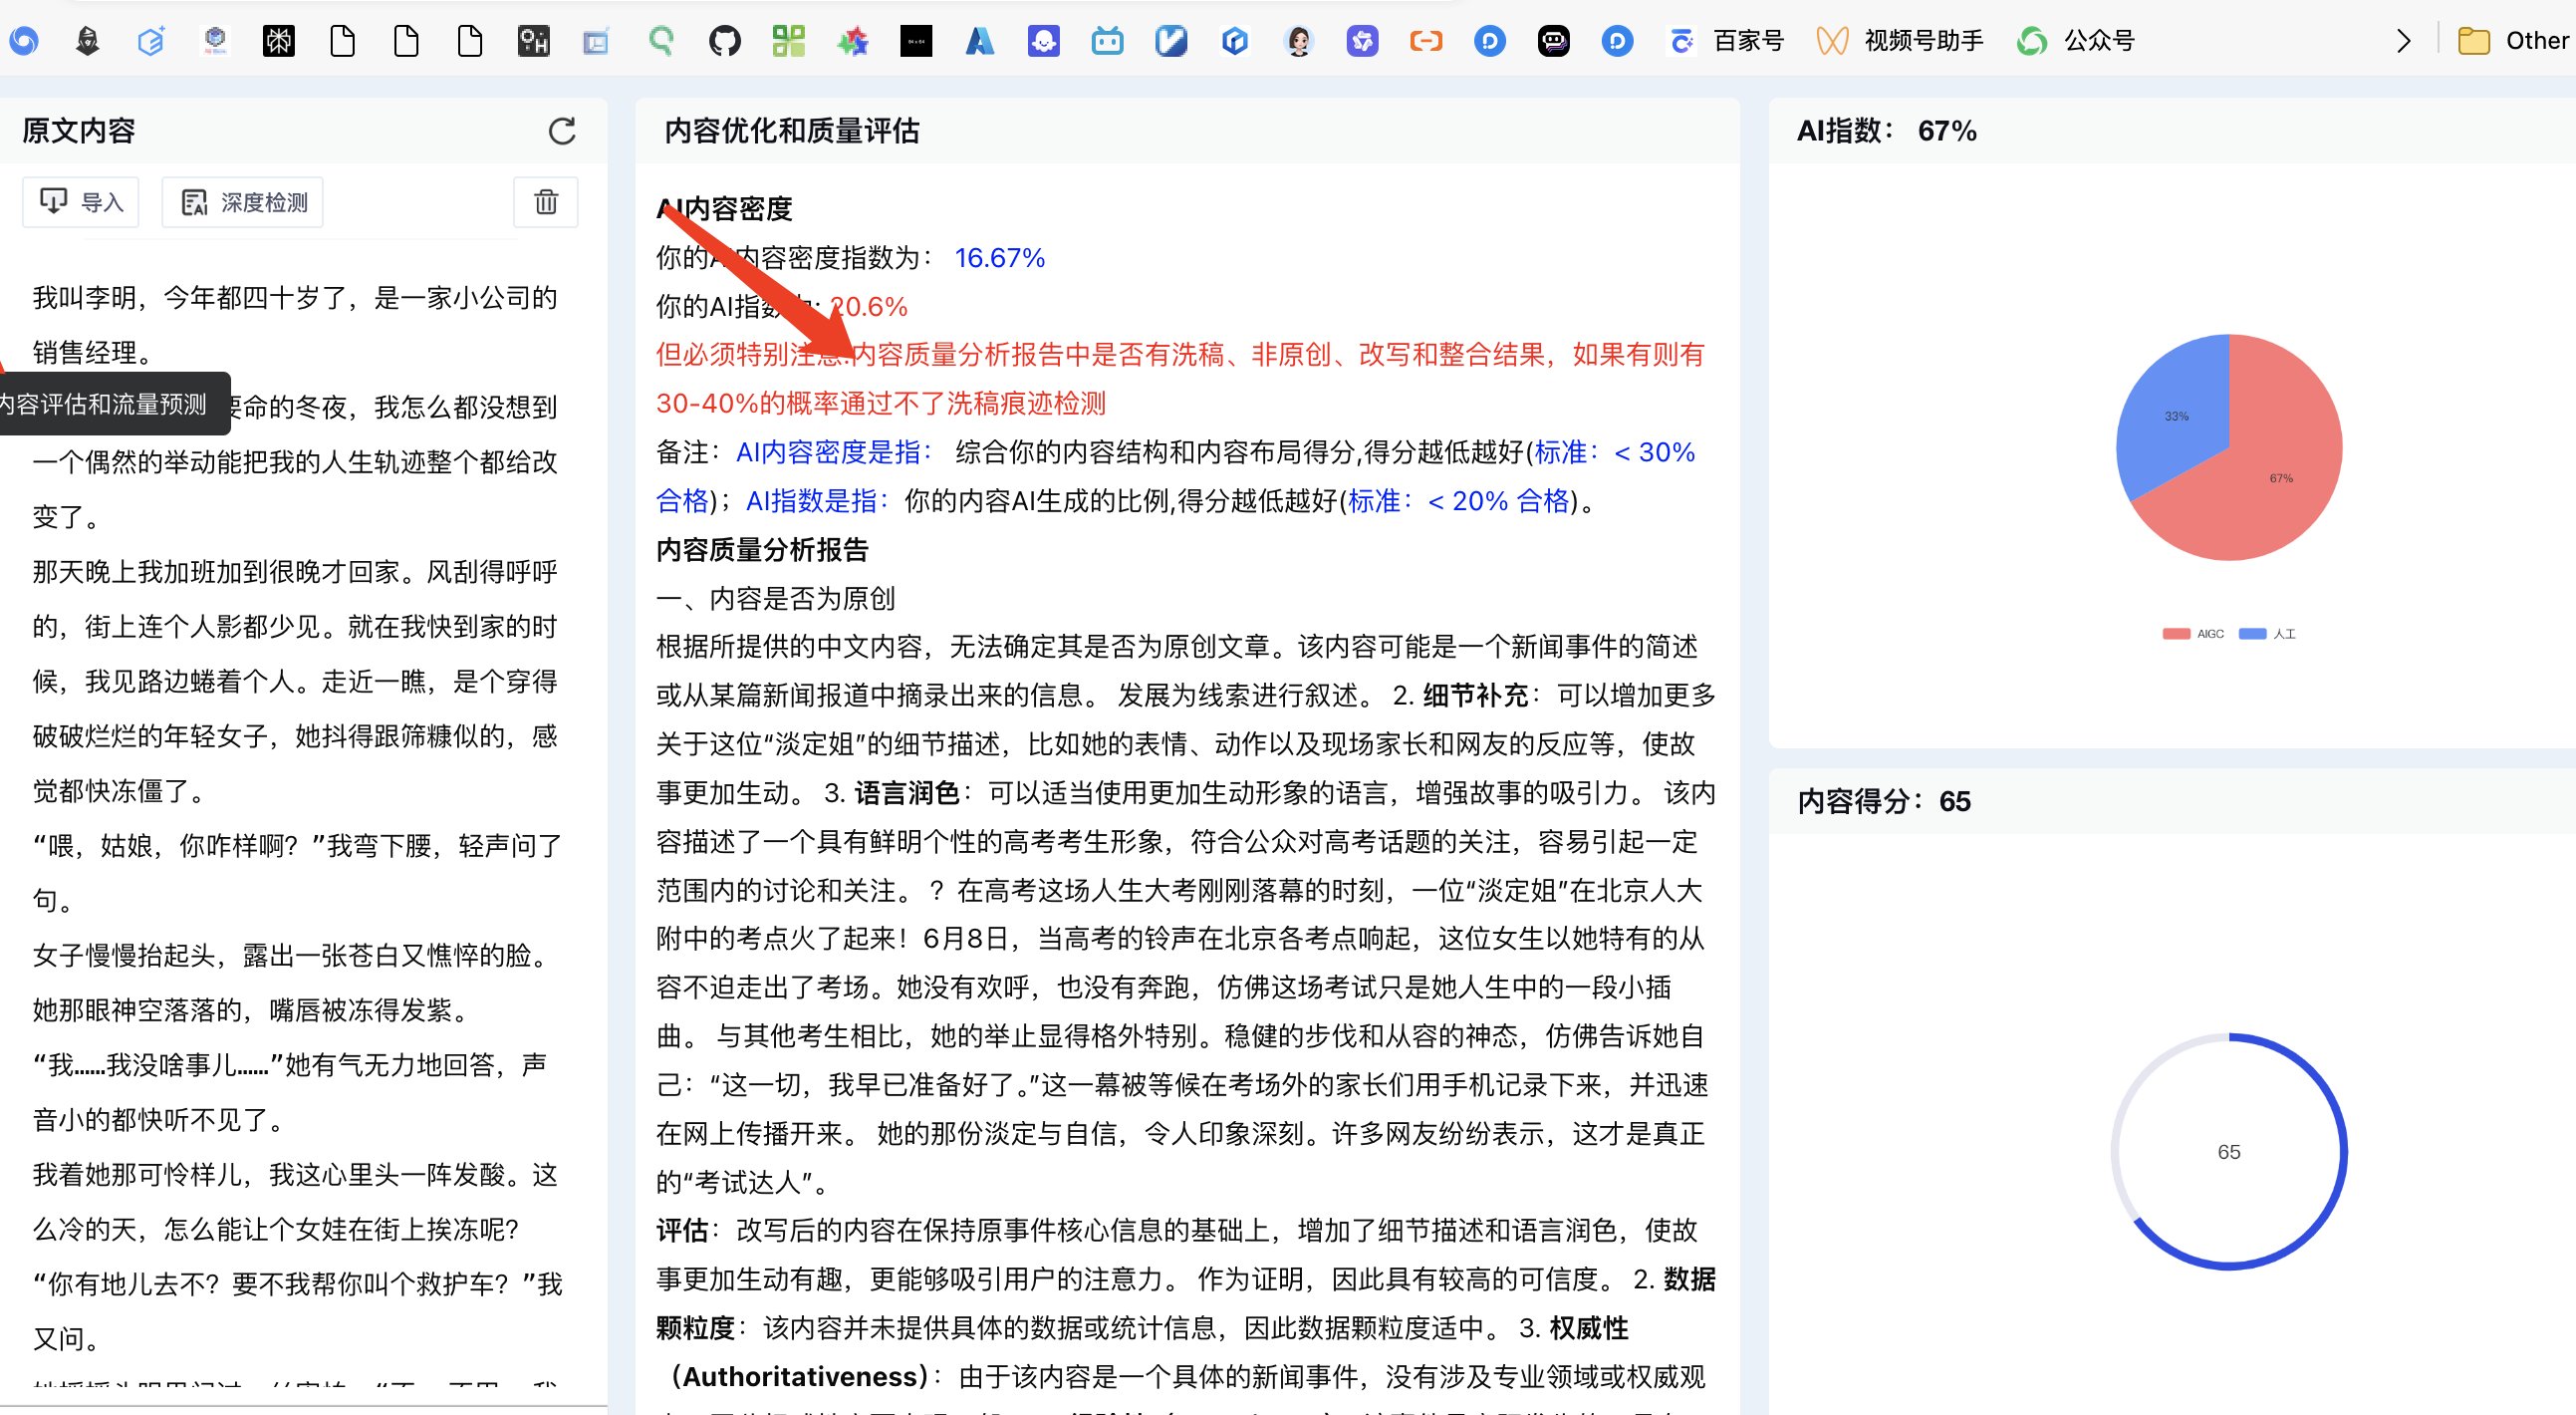
要想搞懂 ContentAny AI 检测原理,得先明白它的核心目标 —— 分辨一篇内容是人类写的还是 AI 生成的。现在 AI 写作工具越来越多,很多平台为了保证内容原创性和真实性,都会用这类检测工具。咱们只有摸透它怎么工作,才能写出更容易通过检测的内容。
🧠 ContentAny AI 检测的核心逻辑:抓 “AI 专属特征”
ContentAny AI 检测不是靠单一标准判断,而是通过捕捉 AI 写作时的 “专属特征” 来下结论。人类写作时,思维是跳跃的,可能会有重复、口语化表达,甚至偶尔出现不太规整的句式。但 AI 写作是基于训练数据生成的,会有一些固定模式。
它会先分析文本的语言规律。比如 AI 写的内容,句子长度可能更均匀,很少有特别短的口语化短句,也很少有过长的、带着个人思考痕迹的复杂句。人类写东西时,可能突然加一句 “对了,这个点忘了说”,这种自然的补充在 AI 生成内容里很少见。ContentAny 就会捕捉这种 “句式均匀度”,如果一篇文章里句子长短几乎没变化,就可能被标为 AI 嫌疑。
还有词汇选择偏好。AI 在生成内容时,会优先用训练数据里出现频率高的 “安全词”,避免生僻表达。比如描述 “好”,人类可能用 “不错”“挺棒”“超出预期”,而 AI 可能反复用 “优秀”“良好” 这类更规范的词。ContentAny 会统计词汇的多样性和个性化程度,词汇越单一、越偏向通用表达,AI 概率就越高。
另外,逻辑连贯性也会被检测。人类写作的逻辑是 “想到哪写到哪”,可能先讲 A,突然联想到 B,再绕回 A,中间有自然的思维跳跃。但 AI 的逻辑是线性的,严格按照 “因为 - 所以”“首先 - 然后” 推进,几乎没有 “意外转折”。如果内容逻辑过于 “完美”,没有人类思维的自然波动,也会被盯上。
🔍 关键技术支撑:两大核心算法在发力
ContentAny 能准确检测,背后靠的是两大核心算法:文本特征提取算法和深度学习对比模型。
文本特征提取算法就像 “扫描仪”,会把内容拆成无数个小细节。它不仅看句子结构、词汇,还会分析标点使用习惯 —— 人类可能多用逗号、句号,偶尔用感叹号表达情绪;AI 用标点更 “规矩”,很少有连续逗号或者突然的感叹号。甚至连段落长度都不放过,人类写段落可能时短时长,AI 则倾向于保持差不多的段落篇幅。这些细节被提取后,会变成数据指标。
深度学习对比模型则是 “判断官”。它用大量的人类文本和 AI 文本训练过,已经形成了 “认知”—— 知道人类写的内容在各项指标上是什么范围,AI 写的又是什么范围。当新内容输入时,它会把提取到的特征和自己 “记忆” 里的人类、AI 特征对比。如果大部分特征都和 AI 特征库重合,就会给出 “高 AI 概率” 的结果。
这个对比过程不是非黑即白的。它会给每个特征打分,比如句式均匀度打 80 分(接近 AI),词汇多样性打 30 分(接近人类),最后综合所有分数得出结论。所以有些 “半 AI” 内容 —— 比如人类修改过的 AI 生成文本,可能会被标为 “中等嫌疑”。
🆚 和其他检测工具的差异:更关注 “自然表达痕迹”
市面上 AI 检测工具不少,ContentAny 的特别之处在于,它不执着于 “语法正确性”,更关注 “自然表达痕迹”。有些工具只要看到语法完美、逻辑顺畅就判定为 AI,但 ContentAny 知道,人类也能写出好文章,所以它把重点放在 “只有人类才会有的表达” 上。
比如它会检测 “冗余信息”。人类写作难免有重复,可能同个观点换种说法再说一遍,或者加一句 “其实刚才说的有点片面”。AI 为了 “高效”,几乎不会有冗余,每个句子都直奔主题。ContentAny 会把这种 “冗余” 当成人类特征,反而觉得有冗余的内容更可能是人类写的。
还有 “情绪波动” 检测。人类写内容时,情绪会通过词汇流露,比如讲喜欢的东西会用 “超爱”“真的绝了”,讲讨厌的会用 “踩雷”“避坑”。AI 虽然能模仿情绪词,但用得比较生硬,比如一直用 “非常推荐”“不建议选择”,缺乏变化。ContentAny 能识别这种情绪表达的 “自然度”,判断是不是人类真实情绪的流露。
另外,它对 “专业领域的个性化表达” 更敏感。比如写科技内容,人类从业者可能会用行业内的 “黑话”“简称”,而 AI 因为训练数据是通用的,可能用全称或者更规范的表达。ContentAny 会结合内容领域,检测是否有这种 “圈子里的表达”,以此提高判断准确性。
✍️ 知道原理后,怎么优化内容才能通过检测?
既然摸清了 ContentAny 的检测逻辑,优化内容就有了方向。核心思路是:模仿人类写作的 “自然感”,减少 AI 特征。
首先,主动增加句式变化。写完后检查一下,把过长的句子拆成短句,比如 “人工智能技术的发展使得各行各业都发生了巨大的变革,尤其是在互联网领域,这种变革表现得更为明显”,可以改成 “人工智能让各行各业都变了样。互联网领域?变化尤其大。” 加入一些短句和设问,打破 AI 式的均匀句式。
其次,刻意用 “个性化词汇”。别总用通用词,多结合自己的表达习惯。比如想说 “很好用”,可以根据场景换 “用着顺手”“没踩雷”“比之前用的顺手多了”。甚至可以加一些个人化的比喻,比如 “这个工具用起来就像带了个助理,不用自己记步骤”,这种独特的比喻 AI 很少会用。
然后,留一点 “思维痕迹”。写的时候不用追求 “一气呵成”,可以加一些自然的转折或补充。比如 “刚才说到这个功能的优点,突然想到它有个小缺点 —— 启动有点慢。不过总体影响不大。” 这种类似 “边想边说” 的表达,能让 ContentAny 捕捉到人类思维的特征。
还要注意 “情绪表达的自然变化”。别从头到尾用一种语气,比如写测评,开头可以说 “刚拿到手时有点失望,包装太简单了”,中间说 “用了两天发现,功能是真的强”,结尾说 “虽然有小缺点,但还是会回购”。这种情绪的起伏,比一直说 “推荐购买,功能优秀” 更像人类写的。
最后,在专业内容里加 “领域黑话”。如果写的是某个行业的内容,适当用从业者才懂的简称或术语。比如写运营,可以说 “这个活动的 ROI 不错,但 CTR 有点低,得优化一下素材”,不用每次都写 “投资回报率”“点击率”。这些 “圈内表达” 能降低被判定为 AI 的概率。
📌 避坑提醒:这些行为会让 AI 概率飙升
知道怎么优化,还要知道哪些坑不能踩。有些做法看似没问题,其实会触发 ContentAny 的 “AI 警报”。
别直接用 AI 生成的内容改几个词就用。AI 生成的内容框架和核心表达还是 AI 特征,只改词汇不改结构,比如把 “优秀” 换成 “出色”,句式和逻辑没变,ContentAny 还是能检测出来。最好的办法是看 AI 生成的内容,理解意思后用自己的话重新写。
别追求 “零错误”。有些人为了通过检测,反复修改让内容语法完美、没有一句废话。但这反而像 AI—— 人类写东西难免有小瑕疵,比如 “这个方法我试过,效果,嗯,确实不错”,中间的停顿和口语化表达,比 “这个方法我试过,效果确实不错” 更自然。
别在短时间内用相同的结构写多篇内容。比如写系列文章,每篇都用 “定义 - 优点 - 缺点 - 总结” 的结构,段落长度也差不多,ContentAny 会觉得这种 “规律性” 像 AI 批量生成的。可以偶尔调整结构,比如先讲案例,再讲定义。
🌟 总结:核心是 “像人类一样思考着写”
ContentAny AI 检测的原理,说到底就是在找 “人类思维的痕迹”。它不反对好内容,只反对 “机器味” 的内容。优化的关键不是去钻检测工具的空子,而是真的像人类一样思考、表达 —— 允许自己有跳跃、有重复、有情绪,不用追求 “完美的表达”。
当你写内容时,别想着 “怎么才能不被当成 AI”,而是想 “如果我跟朋友介绍这个东西,会怎么说”。用这种心态写出来的内容,不仅能通过 ContentAny 检测,读者读起来也会觉得更亲切。毕竟,无论是检测工具还是读者,最终喜欢的都是 “有温度的内容”。
【该文章由diwuai.com
第五 ai 创作,第五 AI - 高质量公众号、头条号等自媒体文章创作平台 | 降 AI 味 + AI 检测 + 全网热搜爆文库🔗立即免费注册 开始体验工具箱 - 朱雀 AI 味降低到 0%- 降 AI 去 AI 味】