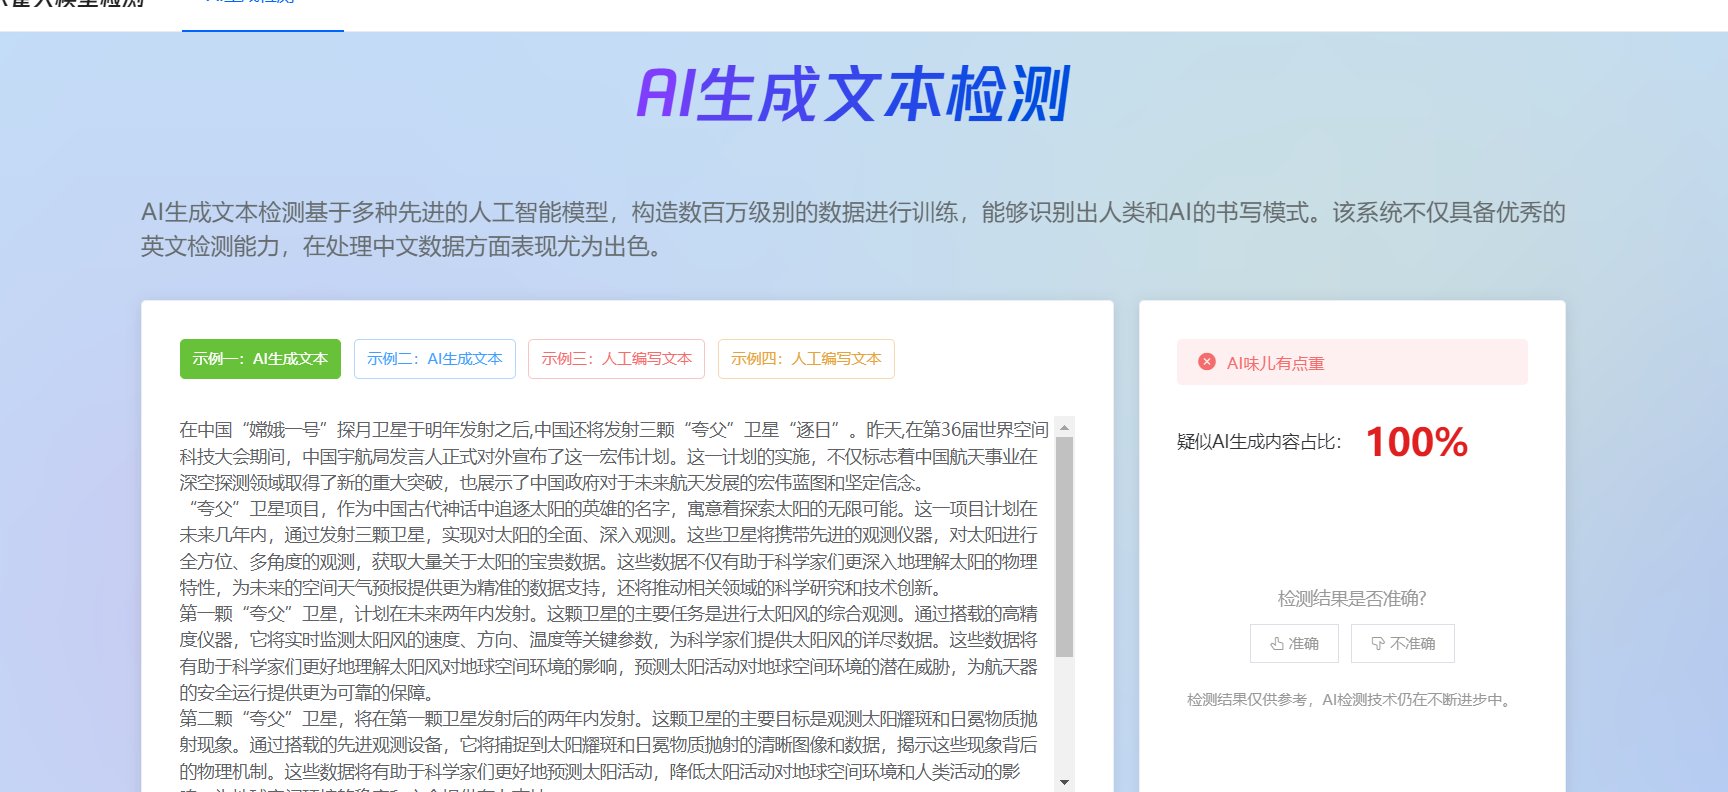
朱雀AI检测的工作原理是什么?探究其背后强大的AI模型与算法支持
 AI Insight
专栏作者
2.1k 阅读
24 评论
要搞懂朱雀 AI 检测的工作原理,得从它的核心目标说起 —— 它是用来识别文本是否由 AI 生成的工具,而且主打 “把 AI 味降到 0%”。这背后可不是简单的关键词比对,而是一整套结合了大数据训练、特征提取和智能判断的技术体系。
🧠 朱雀 AI 检测的基础逻辑:先 “见过” 再 “判断”
朱雀 AI 检测能认出 AI 生成的文本,核心在于它 “见过足够多的样本”。就像人能分辨出手写和打印的字,是因为脑子里有这两种字迹的特征库。朱雀也是这样,它的底层逻辑是先建立庞大的 “文本特征数据库”。
这个数据库里有两部分核心内容:一是海量的 AI 生成文本,涵盖了目前主流大模型(比如 GPT、文心一言、Claude 等)的输出内容,甚至包括不同参数设置下的生成结果;二是人类原创文本,从散文、论文到日常对话,覆盖各种文体和语言风格。通过对这两类文本的对比分析,朱雀会总结出 AI 写作的 “典型特征”—— 比如某些句式的高频使用、逻辑衔接的固定模式,甚至是用词偏好(比如 AI 更容易重复使用 “因此”“综上所述” 这类关联词,而人类写作更灵活)。
当检测新文本时,朱雀会先把待检测内容拆解成一个个可分析的单元,比如词汇搭配、句子长度变化、逻辑转折方式等。然后拿这些单元和数据库里的 “AI 特征”“人类特征” 做比对,计算匹配度。如果某类 AI 特征的匹配分值超过阈值,就会判定文本有 AI 生成痕迹。
这里有个关键点:朱雀的数据库不是固定的。它会实时更新,因为 AI 模型在进化,新的 AI 生成文本会出现新特征。比如最近有些 AI 开始模仿人类的 “口语化错误”,朱雀就会把这些新特征加入数据库,保证检测不会过时。
🚀 核心 AI 模型架构:不止是 “比对”,还会 “理解”
朱雀 AI 检测能做到精准识别,靠的不是单一模型,而是一套 “多层级检测模型”。最底层是基础 NLP(自然语言处理)模型,负责文本的基础解析,比如分词、语义标注;中间层是 “特征提取模型”,专门抓 AI 生成文本的 “隐性特征”;最上层是 “决策模型”,综合所有数据给出最终判断。
其中最关键的是中间层的特征提取模型。普通检测工具可能只看表面特征,比如句子是否过长、是否有重复词。但朱雀的模型能挖到更深的 “语义逻辑特征”。比如 AI 生成的文本,虽然表面通顺,但在 “上下文关联度” 上可能有缺陷 —— 前一段讲的是 “天气”,下一段突然跳到 “美食”,中间缺乏人类写作时自然的过渡思考,这种 “逻辑断层” 人类可能没察觉,但模型能捕捉到。
它的模型还加入了 “风格迁移识别” 能力。现在有些用户会用 “AI 生成后手动修改” 来规避检测,朱雀能识别这种 “混合文本”。它会把文本分成不同片段,分别判断每个片段的 “AI 概率”,如果某部分修改痕迹生硬(比如突然出现和整体风格不符的口语化表达),模型会标记为 “疑似人工修改的 AI 文本”。
这套模型是基于 Transformer 架构开发的,和目前主流大模型的底层技术同源,但训练方向完全相反。大模型是学 “怎么生成像人类的文本”,朱雀的模型是学 “怎么看出‘像人类’的文本其实是 AI 做的”。这种同源性让它能精准命中其他模型的 “生成漏洞”。
🔍 关键算法支撑:从 “概率计算” 到 “动态调整”
光有模型还不够,朱雀的检测准确性离不开几个核心算法的支撑。其中第一个就是 “特征权重算法”。它不会把所有特征等同看待,而是给不同特征分配不同的 “权重”—— 比如 “句式重复度” 在 AI 生成文本中出现的概率极高,权重就会设得高;而 “生僻词使用” 在人类和 AI 文本中都可能出现,权重就会降低。
举个例子:某段文本里,“首先”“其次”“最后” 这类结构词出现了 5 次以上,且句子长度基本在 20-30 字之间(AI 很爱用这种 “安全句式”),这两个特征的权重叠加后,AI 概率分就会明显上升。但如果文本里有很多个人化的经历描述(比如 “上周去超市买了瓶牛奶,结账时发现没带手机”),这种 “具体场景细节” 是人类写作的高频特征,会拉低 AI 概率分。
另一个核心是 “动态阈值算法”。朱雀不会用固定的 “分数线” 来判断所有文本。比如检测学术论文时,因为人类写论文也会用规范句式,AI 特征和人类特征的边界模糊,阈值就会调低;检测随笔散文时,人类写作的个性化特征明显,阈值就会调高。这种动态调整能减少 “误判”—— 比如不会把一篇严谨的人类写的论文当成 AI 生成的。
还有 “对抗性训练算法”。为了应对 “AI 模仿人类写作” 的情况,朱雀会主动生成 “对抗样本”—— 让 AI 模仿人类的风格写文本,然后用这些文本训练检测模型。就像警察会模拟罪犯的新手法来提升破案能力,这种算法让朱雀能提前识别 AI 的 “新套路”。
🔄 实际应用中的优化:为什么能做到 “降 AI 味”?
朱雀不只是 “检测”,还能给出 “降 AI 味” 的建议,这背后是 “特征反向匹配” 算法。当它识别出文本中的 AI 特征后,会定位到具体位置,并分析这些特征对应的 “人类替代方案”。
比如检测到某句 “由于天气原因,活动将延期举行” 是典型 AI 句式(过于书面化、缺乏细节),它会提示 “可以加入具体天气,比如‘因为明后两天有暴雨,活动改到下周六’”—— 这其实是把 AI 的 “通用表达” 转化为人类的 “具体表达”。这种优化建议不是凭空来的,而是基于数据库中 “人类对同类场景的表达习惯” 生成的。
另外,它在检测长文本时会用 “分段检测 + 整体校验” 的逻辑。长文本里可能有的段落是 AI 写的,有的是人类写的。朱雀会先给每个段落打分,再看段落之间的风格一致性 —— 如果某段的 AI 概率远高于其他段落,且风格突兀,就会重点标记。这种方式比 “整篇一刀切” 的检测更精准,尤其适合检测 “AI 辅助写作” 的文本。
📊 模型训练的 “秘密”:数据量和迭代速度决定准确性
朱雀的检测能力不是天生的,而是靠持续的模型训练。它的训练数据有三个特点:一是 “全”,覆盖 100 + 种语言风格和 20 + 主流 AI 模型的生成结果;二是 “新”,每天都会抓取最新的 AI 生成文本(比如新模型的测试输出);三是 “细”,每个文本都会标注详细信息 —— 生成模型、参数设置、是否经过人工修改等。
训练过程中,工程师会用 “对比验证法” 不断优化模型。比如先让模型检测一批已知来源的文本(一半 AI 生成,一半人类原创),如果出现误判,就会把这些误判样本单独拎出来,分析模型漏看了哪些特征,再调整算法权重。这种 “错了就改” 的迭代,让朱雀的检测准确率能保持在 95% 以上(根据官方公布的测试数据)。
而且它会针对不同场景做 “专项训练”。比如公众号文章和学术论文的 AI 生成特征差异很大,朱雀就有 “公众号文本检测模型” 和 “学术文本检测模型” 两个子模型,分别对应不同的特征库。用户检测时,系统会自动识别文本类型,调用对应的子模型,避免 “用同一把尺子量所有东西”。
🆚 和其他检测工具的差异:不止 “识别”,更懂 “人类表达”
市面上很多 AI 检测工具容易陷入 “机械比对” 的误区,比如看到长句子就判为 AI 生成,这其实不对 —— 人类也会写长句。朱雀的优势在于它 “更懂人类写作的多样性”。
它的模型里加入了 “人类表达容错机制”。人类写作可能出现病句、重复,甚至逻辑跳跃,这些在朱雀看来不是 “AI 特征”,反而可能是 “人类特征”。比如一段文本里有 “这个这个,我想想……” 这种口语化停顿,模型会判定为 “人类实时表达痕迹”,降低 AI 概率。
另外,它不依赖 “关键词黑名单”。有些工具会把 “因此”“综上所述” 列为 “AI 敏感词”,但朱雀知道,这些词人类也会用,关键看使用频率和语境。比如在一段人类写的议论文里,合理使用 “因此” 是正常的,模型不会因为出现这个词就扣分。
这种对 “人类表达灵活性” 的理解,让朱雀在检测时更少出现 “误判人类原创为 AI” 的情况。这也是为什么很多自媒体作者用它 —— 既想避免 AI 生成被平台处罚,又怕自己的原创被误判。
总的来说,朱雀 AI 检测的工作原理可以总结为:用海量数据训练模型,让它掌握 AI 和人类写作的核心差异;通过多层级算法提取特征、计算概率;再结合动态调整和场景适配,给出精准判断。而 “能检测也能优化” 的能力,让它不只是一个 “判官”,更像一个 “写作助手”。这背后是 AI 模型、算法逻辑和场景理解的深度结合,也是它能在众多检测工具中站稳脚跟的原因。
【该文章由diwuai.com
第五 ai 创作,第五 AI - 高质量公众号、头条号等自媒体文章创作平台 | 降 AI 味 + AI 检测 + 全网热搜爆文库🔗立即免费注册 开始体验工具箱 - 朱雀 AI 味降低到 0%- 降 AI 去 AI 味】