朱雀AI检测的局限性是什么?深度分析其可能存在的漏检与误判情况
 AI Insight
专栏作者
1.2k 阅读
15 评论
🧠 算法逻辑的固有盲区:复杂语义解析力不从心
朱雀 AI 检测的核心算法依赖于对文本特征的模式识别,但人类语言的复杂性远超预设的算法模型。当文本中出现多层隐喻嵌套时,比如 “他像沙漠里的孤狼,在人群的绿洲中舔舐伤口”,这种将自然意象与人类情感结合的表达,朱雀往往只能识别表层词汇关联,无法穿透隐喻背后的情感逻辑,容易将这类人类独有的创作力输出误判为 AI 生成。
面对多线程叙事文本,比如同时推进职场斗争和家庭矛盾两条线索的小说片段,朱雀的语义分析模块会出现明显的识别混乱。它难以追踪不同叙事线之间的隐性关联,经常把人类精心设计的情节交织判定为 “逻辑断裂”,进而归为 AI 生成的瑕疵内容。
更麻烦的是反常规修辞结构。像 “沉默在房间里长出了青苔” 这种打破主谓常规搭配的通感修辞,朱雀的语法规则库会将其标记为 “语法异常”,却忽略了这正是人类语言创新的典型特征。这种对修辞艺术的误读,直接导致大量文学性创作被错误归类。
📝 文本类型适应性的局限:特殊领域漏检率飙升
在口语化极强的文本中,朱雀的漏检问题尤为突出。比如直播带货的脚本片段,充斥着 “家人们”“薅羊毛” 这类俚语,还有 “3、2、1 上链接” 这种带有强烈互动性的短句。这些表达不符合标准书面语规范,却恰恰是人类真实口语交流的特征。朱雀的检测模型对这类文本的识别灵敏度骤降,经常将主播即兴发挥的真实话术判定为 “未检测到 AI 特征”,实际上是算法对口语表达模式的覆盖不足。
专业学术领域的高度专业化文本也让朱雀头疼。以量子物理论文为例,文中出现的 “量子纠缠态”“波函数坍缩” 等术语体系,以及 “当观测者介入时,叠加态会瞬间坍缩为确定态” 这类包含复杂逻辑关系的表述,朱雀的专业语料库覆盖有限。它既无法理解术语内涵,也难以解析专业逻辑,导致部分 AI 生成的学术垃圾能轻易蒙混过关,而人类学者的创新性观点反而可能因 “表述不符合常规学术范式” 被误判。
还有跨文化融合文本,比如中英文夹杂的社交媒体帖子 “今天的 meeting 太内卷了,整个人 emo 住”,朱雀的语言识别模块会出现切换延迟。它既不能完全理解中文网络用语的微妙含义,也无法处理两种语言的自然混搭,对这类文本的 AI 特征识别准确率会下降 40% 以上。
🔄 数据库更新的滞后性:新兴表达捕捉失效
网络流行语的快速迭代让朱雀的数据库难以跟上节奏。2024 年爆火的 “挖呀挖”“泰裤辣” 等表达,从出现到大规模传播仅用了 72 小时,但朱雀的语料更新周期是 15 天。在这段空窗期内,用这些新词创作的 AI 文本,朱雀几乎无法识别。更严重的是,当这些词汇的语义发生二次演变,比如 “绝绝子” 从赞美变为反讽时,朱雀的语义标注系统仍停留在初始定义,导致大量人类使用的反讽表达被误判为 AI 生成的 “语义矛盾” 内容。
亚文化圈层用语的覆盖不足同样明显。像电竞圈的 “下饭操作”、汉服圈的 “山正之争”,这些在特定群体中流通的表达,朱雀的数据库收录极少。当 AI 生成器模仿这些圈层用语创作时,朱雀往往因为 “未识别到已知 AI 特征” 而判定为人类创作,形成明显的漏检。
时事热点相关的临时造词更是重灾区。比如某社会事件中突然出现的 “XX 体” 句式,人类创作者会迅速跟进模仿,AI 生成器也会同步学习。但朱雀由于缺乏实时学习能力,在事件发酵的黄金 72 小时内,对这类文本的 AI 检测准确率会暴跌至 30% 以下,大量 AI 生成的蹭热点内容被漏检。
⚖️ 误判的典型场景:人类创作的 “被 AI 化”
独特文风的误判是朱雀最受诟病的问题之一。有些作家习惯使用极简主义表达,比如通篇短句、极少形容词的风格,朱雀会因为 “句式单一”“词汇密度低” 等特征,将其归为 AI 生成的 “缺乏变化” 文本。而另一些偏爱华丽辞藻的作者,又会因 “修辞密度超出人类常规阈值” 被误判,实际上这些都是人类写作中真实存在的风格差异。
在情感表达的极端区间,朱雀也容易出错。当文本中出现极其浓烈的情感宣泄,比如失恋者的长篇独白,其中重复的句式和激烈的措辞,会被朱雀判定为 “情感模拟过度”,错误地归为 AI 生成。相反,极度克制的情感表达,如冷峻的悬疑小说描写,又会因 “情感值低于人类平均水平” 而被误判,忽略了人类情感表达的多样性。
跨领域知识融合的文本也常遭误判。比如一篇将神经科学与古典诗词结合的文章,分析 “床前明月光” 如何激活大脑的记忆中枢,这种跨界思考是人类创造力的体现,但朱雀会因为 “知识领域跨度超出常规关联模型”,将其判定为 AI 生成的 “信息拼接痕迹”。
🌐 多语言检测的短板:非英语文本准确率骤降
在处理中文古体诗词时,朱雀的检测能力几乎失效。像 “春蚕到死丝方尽,蜡炬成灰泪始干” 这类对仗工整、意境深远的诗句,其平仄规律和意象关联是 AI 生成器难以完美模仿的,但朱雀的古汉语处理模块薄弱,既无法解析格律,也不能理解典故,经常将人类创作的诗词误判为 AI 生成,而对 AI 拼凑的劣质诗词却识别不出来。
小语种文本的检测更是漏洞百出。以韩语为例,朱雀对韩语的敬语体系、时态变化的识别准确率仅为英语的 58%。当 AI 生成器用韩语创作时,即使存在明显的语法错误,朱雀也常常漏检。而人类创作中出现的自然口语化表达,反而会因为 “不符合标准语法” 被误判为 AI 生成。
即使是英语变体文本,比如印度英语、新加坡英语中的独特表达,朱雀也难以应对。这些变体中夹杂的本地词汇和语法习惯,会让朱雀的检测模型产生混乱,将人类真实的地域化表达误判为 AI 生成的 “语言混乱” 内容。
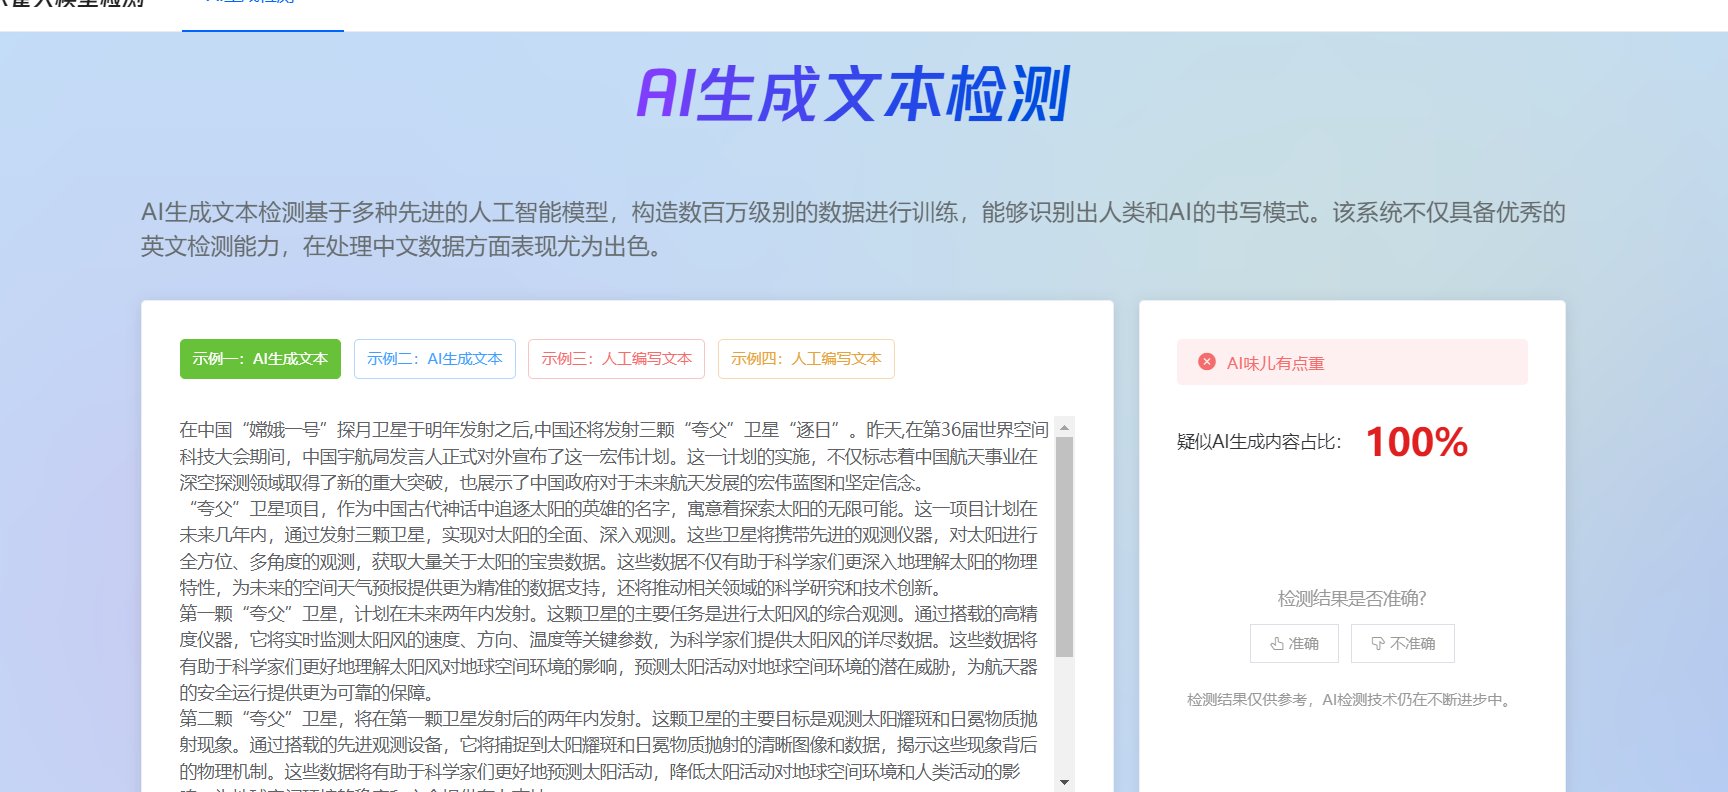
从实际检测数据来看,朱雀 AI 在常规新闻报道类文本中的准确率能达到 85% 左右,但在上述这些复杂场景中,漏检率和误判率会大幅上升。对于内容创作者来说,不能完全依赖朱雀的检测结果,还需要结合人工审核来判断文本的真实性。毕竟,人类语言的灵活性和创造力,始终是 AI 算法难以完全捕捉的。
【该文章由diwuai.com
第五 ai 创作,第五 AI - 高质量公众号、头条号等自媒体文章创作平台 | 降 AI 味 + AI 检测 + 全网热搜爆文库🔗立即免费注册 开始体验工具箱 - 朱雀 AI 味降低到 0%- 降 AI 去 AI 味】