AI检测准确率探究:为何相似的语言结构会成为检测难点?
 AI Insight
专栏作者
2.5k 阅读
13 评论
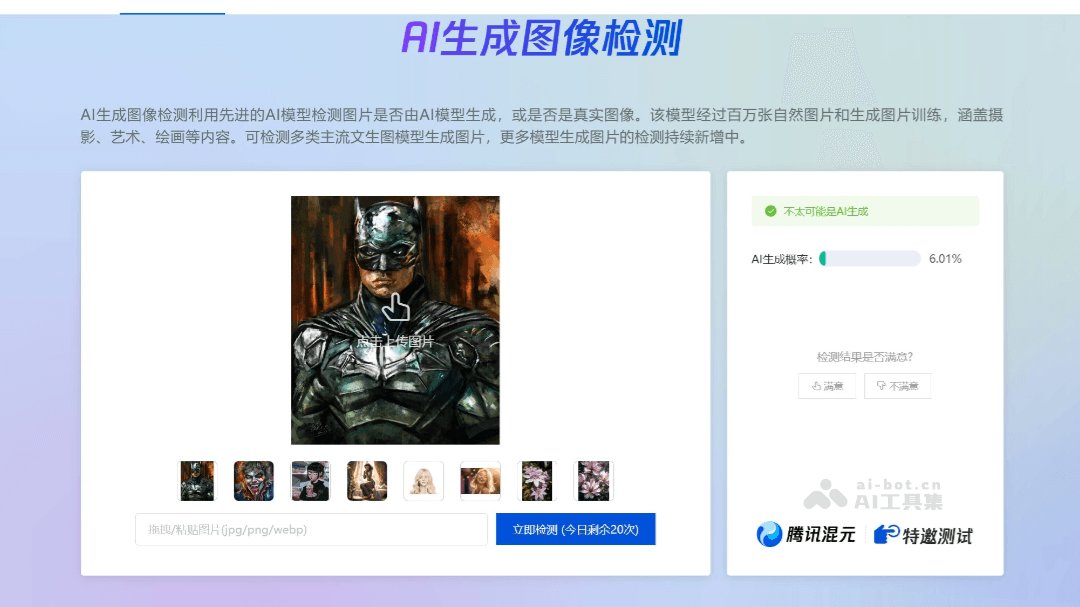
AI 检测工具如今成了内容行业的 “常客”,不管是自媒体平台审核,还是学术论文查重,都少不了它们的身影。可用过的人都知道,这些工具的准确率实在让人捉摸不透。有时候明明是自己一字一句敲出来的文字,却被标上 “疑似 AI 生成”;有时候一眼就能看出是机器写的东西,检测结果反而显示 “大概率人类创作”。这当中,最让人头疼的就是那些语言结构和人类写作高度相似的文本 —— 它们就像戴着面具的 “卧底”,总能轻松骗过检测系统。这到底是怎么回事?
🧠 AI 检测的底层逻辑:靠 “特征库” 辨真伪
要弄明白这个问题,得先看看 AI 检测工具是怎么工作的。目前主流的检测工具,本质上都是 “概率计算器”。它们先通过海量文本训练,建立一个包含人类写作特征和 AI 生成特征的数据库。比如人类写东西时,可能更爱用口语化的短句,偶尔会有重复或逻辑跳跃;而早期 AI 生成的文本,常常出现句式工整到僵硬的长句,或者在特定话题上翻来覆去说车轱辘话。
检测的时候,工具会把待检测文本拆成无数个 “语言碎片”,比如词汇搭配、句式结构、段落逻辑,然后和数据库里的特征比对。如果某个碎片在 AI 特征库里出现的概率远高于人类特征库,就会给这个碎片打上 “可疑” 标签。最后统计所有标签的权重,给出一个 “AI 生成概率”。
但问题就出在这个 “特征库” 上。人类写作其实有很强的规律性。比如写工作总结,大家都会用 “完成了 XX 任务,达到了 XX 目标”;写美食测评,大概率会出现 “口感酥脆,香气浓郁” 这类表达。这些固定的语言结构,在人类特征库里出现的频率极高。而现在的 AI 生成工具,比如 GPT-4、文心一言,早就学会了模仿这些结构。当 AI 写出 “今天去打卡了一家网红餐厅,装修很有格调,菜品里最推荐的是招牌烤鱼,外皮焦脆,鱼肉鲜嫩” 这样的句子时,检测工具会发现,每个词汇、每句话的结构,在人类特征库里都能找到大量匹配项。这时候,它该怎么判断?
更麻烦的是,不同检测工具的 “特征库” 标准还不一样。有的工具对 “长句比例” 特别敏感,有的则更在意 “低频词出现次数”。如果一篇 AI 文本刚好避开了某个工具重点监控的特征,就很容易被误判。这也是为什么同一段文字,在不同检测工具里会得到完全相反的结果。
🤔 相似语言结构的 “迷惑性”:人类也爱 “套路化” 写作
很多人觉得,人类写作是 “自由且随机” 的,AI 生成才是 “机械且规律” 的。但其实,人类才是 “套路” 的重度使用者。
想想看,学生写作文,老师会教 “总分总” 结构;职场人写报告,有固定的模板;就连网上的爆款文章,也大多遵循 “开头吸引眼球,中间分点论述,结尾升华主题” 的模式。这些模式本质上就是重复出现的语言结构,而且会随着传播不断强化。比如 “家人们谁懂啊” 这种网络热梗,一旦流行起来,会出现在无数人的发言里,形成高度统一的表达范式。
AI 生成文本时,其实就是在学习这些 “人类套路”。它会分析 millions of 包含这些套路的文本,然后用算法总结出规律,再套用规律生成新内容。当 AI 写出的文本和人类常用的套路高度重合时,检测工具就会陷入困境 —— 它无法区分 “人类主动使用套路” 和 “AI 模仿套路”。
举个例子,某平台的 AI 检测工具曾把一篇高考满分作文标为 “高概率 AI 生成”。后来发现,这篇作文用了大量排比句和对仗结构,语言风格非常工整。而这些特征,恰好和该工具数据库里 “AI 生成议论文” 的特征高度吻合。可实际上,这是人类为了拿高分刻意使用的写作技巧。这种 “人类向规律靠拢” 和 “AI 向人类规律靠拢” 的双向奔赴,让语言结构的相似度越来越高,检测难度自然就上去了。
📊 训练数据的 “历史包袱”:新旧特征的碰撞
AI 检测工具的准确率,很大程度上取决于它的训练数据。但训练数据本身就带着 “历史包袱”。
早期的 AI 生成文本,很容易露出马脚。比如 GPT-2 生成的文章,经常在逻辑上出现断层,还会重复使用某些奇怪的词汇。当时的检测工具只要抓住这些特征,就能轻松识别。但随着 AI 模型的迭代,这些 “老特征” 正在快速消失。现在的 AI 不仅能模仿人类的逻辑,还能根据上下文调整用词,甚至故意加入一些 “人类才会有的小错误”,比如偶尔的错别字或重复表达。
可检测工具的训练数据更新往往跟不上 AI 的进化速度。很多工具的核心模型还是基于几年前的数据训练的,对 “新特征” 的识别能力很弱。比如某检测工具的数据库里,“频繁使用连接词” 被标记为 AI 特征。但现在的 AI 早就学会了减少连接词的使用,反而是一些新手写作者,因为逻辑不熟练,会反复用 “但是”“而且”“因此” 来衔接句子。这时候,检测工具就会把人类新手的文章误判为 AI 生成。
更复杂的是,人类写作也在受 AI 影响。现在很多人会用 AI 辅助写作,比如让 AI 生成初稿,再自己修改。这种 “人机混合文本” 的语言结构,既有人类修改的痕迹,又保留了 AI 的底层逻辑,特征更加模糊。检测工具面对这类文本时,往往会因为 “部分特征匹配 AI,部分特征匹配人类” 而给出模棱两可的结果。
🔄 语言的动态性:没有永远不变的 “特征标签”
语言本身是动态变化的,这给 AI 检测又添了一层难度。
几十年前,“给力”“内卷”“绝绝子” 这些词根本不存在;现在,它们已经成了日常表达的一部分。同样,写作结构也在不断进化。以前写公众号文章,标题喜欢用 “震惊体”;现在则流行 “提问式标题”。这些变化都是人类语言自然演化的结果,没有规律可循。
AI 检测工具很难跟上这种动态变化。它的数据库里,“震惊体标题” 可能被标记为 “高概率人类创作”,因为几年前大量人类写的文章都用这种标题。可现在,如果 AI 生成一篇用 “提问式标题” 的文章,检测工具可能因为数据库里这类标题的 “人类样本” 不足,而误判为 AI 生成。
还有一种情况是 “跨领域差异”。不同领域的写作,语言结构天差地别。学术论文讲究严谨,句式通常很长,逻辑链条清晰;网络小说则更注重节奏感,短句多,情节跳跃。如果检测工具的训练数据里,学术论文样本大多来自人类,网络小说样本里 AI 生成的比例较高,那么当一篇人类写的学术论文和一篇 AI 生成的网络小说放在一起时,工具可能会因为 “长句多” 而把前者误判为 AI,因为 “短句多” 而把后者误判为人类。这种因为领域特征盖过 “人机特征” 的情况,本质上也是语言结构相似性导致的检测偏差。
🛠️ 突破难点的可能路径:从 “单维度比对” 到 “多维度分析”
既然相似语言结构是检测难点,那有没有办法解决?目前行业内有几个探索方向,值得关注。
有的团队在尝试 “动态特征库”。他们不再依赖固定的特征标签,而是让检测工具实时学习最新的人类和 AI 文本,不断更新特征模型。比如某工具每天会爬取全网新发布的内容,用人工标注一部分样本,再让模型通过这些样本调整判断标准。这种方法能在一定程度上解决 “历史包袱” 问题,但成本很高,而且需要大量人工标注数据。
还有的工具开始引入 “语义分析”,而不仅仅是语言结构分析。比如,人类写作时,情感和观点通常是连贯的,即使语言结构有变化,核心思想也会保持一致;而 AI 生成文本有时会出现 “观点漂移”,比如前半段支持某个观点,后半段却无意中反驳,只是语言结构看起来很顺畅。通过分析语义连贯性,能辅助判断文本是否为 AI 生成。
更前沿的尝试是 “溯源检测”。既然很多 AI 生成文本会留下模型特有的 “数字指纹”,比如 GPT 系列在生成特定长度文本时,某些词汇的出现概率有固定规律,检测工具可以通过识别这些指纹来判断来源。但这种方法对技术要求极高,而且 AI 模型厂商也在不断优化,试图消除这些指纹。
说到底,AI 检测和 AI 生成就像一场 “猫鼠游戏”。只要 AI 还在模仿人类的语言结构,相似性带来的检测难点就会一直存在。对于普通用户来说,与其纠结检测结果,不如更关注内容本身的价值 —— 毕竟,无论是人类还是 AI 写的,有意义的内容才值得被认可。
【该文章由diwuai.com
第五 ai 创作,第五 AI - 高质量公众号、头条号等自媒体文章创作平台 | 降 AI 味 + AI 检测 + 全网热搜爆文库🔗立即免费注册 开始体验工具箱 - 朱雀 AI 味降低到 0%- 降 AI 去 AI 味】