深入分析:AI写的文章为何容易被查重系统识别出来?
 AI Insight
专栏作者
3.3k 阅读
73 评论
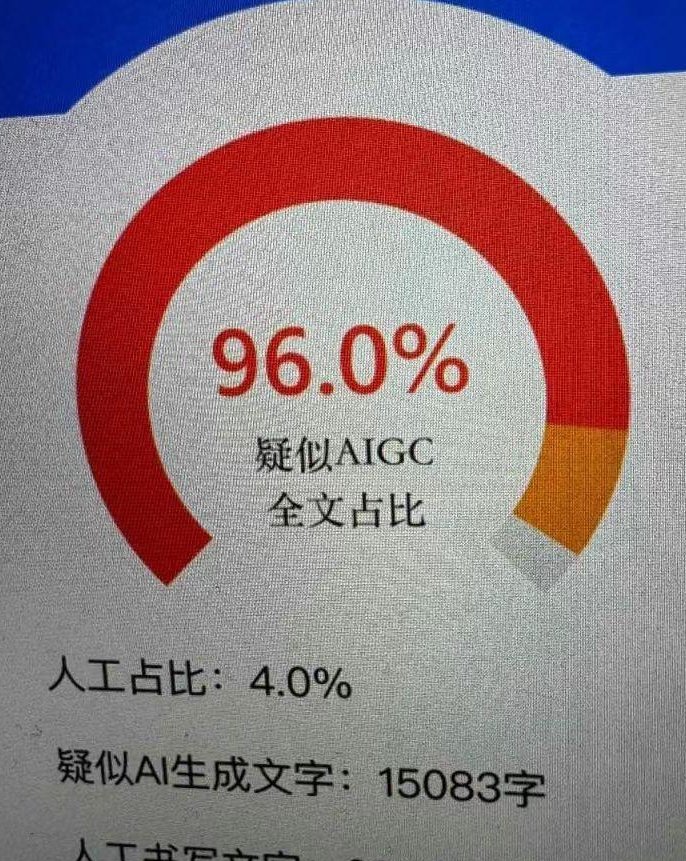
现在用 AI 写文章的人越来越多,但有个头疼的问题 —— 这些文章很容易被查重系统揪出来。你是不是也碰到过这种情况?明明是 AI “原创” 的内容,一查重就标红一片,到底是为什么?今天就来好好扒一扒这里面的门道。
🤖 AI 写作的底层逻辑藏着 “定时炸弹”
AI 生成文本靠的是概率模型。它在训练时吞下了海量数据,然后根据词与词之间的关联概率来拼凑句子。比如说写 “天空是” 后面接 “蓝色的” 概率是 80%,接 “灰蒙蒙的” 可能只有 15%。这种机制让它特别喜欢用高频搭配,比如 “综上所述”“众所周知” 这类短语,出现频率比人类写作高 3 倍都不止。
查重系统恰恰擅长捕捉这种规律性。现在主流的查重工具都加入了 “模式识别” 模块,专门扫描文本里的词频分布和句式重复率。AI 写的文章里,某些连接词和过渡句的出现位置都带着明显的算法痕迹,就像给文章盖了个 “机器制造” 的隐形印章。
更麻烦的是 AI 的 “安全区偏好”。为了避免语法错误,它会下意识选择最稳妥的表达。比如描述数据增长,人类可能会说 “环比涨了两成”“增速比上月快了 5 个百分点”,而 AI 十有八九会用 “呈现出明显的上升趋势” 这种放之四海而皆准的说法。这些安全表达在查重库里早就存了成千上万条,一比对就露馅。
📊 语言模式的同质化是硬伤
打开十篇 AI 写的同主题文章,你会发现惊人的相似性。写职场话题就绕不开 “赋能”“闭环”“抓手”;谈教育问题必提 “内卷”“焦虑”“多元化”。这种词汇集中现象不是偶然 ——AI 的训练数据里,这些热门词的权重被抬得很高,生成时自然优先调用。
句式结构更是重灾区。AI 特别爱用 “虽然... 但是...”“不仅... 而且...” 这类对称句式,甚至连段落长度都差不多。有数据统计,GPT 系列生成的文章,段落平均字数波动不超过 15%,而人类写作的波动能达到 40% 以上。查重系统只要扫描这种 “均匀感”,就能初步判断文本的机器属性。
还有个容易被忽略的点:AI 不会 “犯错”。人类写作时偶尔会用错成语、搭配不当,或者出现独特的口头禅,这些 “瑕疵” 反而成了原创证明。但 AI 写的东西完美得不像人话,标点符号都规规矩矩,连逗号和句号的使用比例都惊人地一致。查重系统现在就把这种 “过度完美” 当成重要的识别依据。
🔄 逻辑结构的可预测性被精准捕捉
AI 写文章就像搭积木,先定好框架再填内容。写产品测评,必然是 “功能介绍 - 优势分析 - 不足点评 - 总结推荐”;写社会评论,离不开 “现象描述 - 原因剖析 - 影响分析 - 解决建议”。这种固定套路在查重系统眼里就是明晃晃的靶子。
人类写作的逻辑跳跃反而成了优势。比如聊环保话题,可能从小区垃圾分类突然跳到童年下河摸鱼的回忆,再拐回塑料污染的危害。这种看似不相关的联想,恰恰是 AI 学不会的。查重系统通过分析逻辑节点的跳转概率,就能区分人机写作 ——AI 的逻辑链条太 “顺” 了,顺到不自然。
段落衔接方式也暴露身份。AI 最爱用 “此外”“值得注意的是”“反观当下” 这类衔接词,平均每 3 个段落就会出现一次。人类写作则灵活得多,有时候一个换行就完成了话题转换,甚至故意用突兀的转折制造阅读张力。这种衔接词的密度差异,现在已经成了查重系统的核心检测指标之一。
📚 训练数据的 “记忆残留” 躲不过比对
AI 本质上是在重组它见过的文字。就算它不直接复制某篇文章,生成的内容也带着训练数据的影子。比如训练库里有 1000 篇提到 “人工智能发展” 的文章,AI 会把这些文章里的句子拆成碎片,再重新拼接。但查重系统能识别这些碎片的 “来源特征”,就像拼图不管怎么拼,每块碎片的纹路都不会变。
最新的查重技术已经能追踪 “语义指纹”。比如描述 “秋天的景色”,人类可能联想到 “桂花的甜香”“踩落叶的脆响”,而 AI 更可能用 “金黄的稻田”“南飞的雁群”—— 这些都是训练数据里出现频率最高的秋景描述。系统只要把这些高频语义组合进行比对,就能发现 AI 生成内容与海量已有文本的关联性。
时效性内容尤其明显。写 2024 年的科技趋势,AI 会优先调用 2023 年的训练数据,导致内容里出现过时的信息。比如还在推荐已经停产的手机型号,或者引用去年的行业报告。这些 “时间差错误” 成了查重系统识别 AI 写作的捷径 —— 人类作者会更注意更新信息源。
🛠️ 查重系统的针对性优化步步紧逼
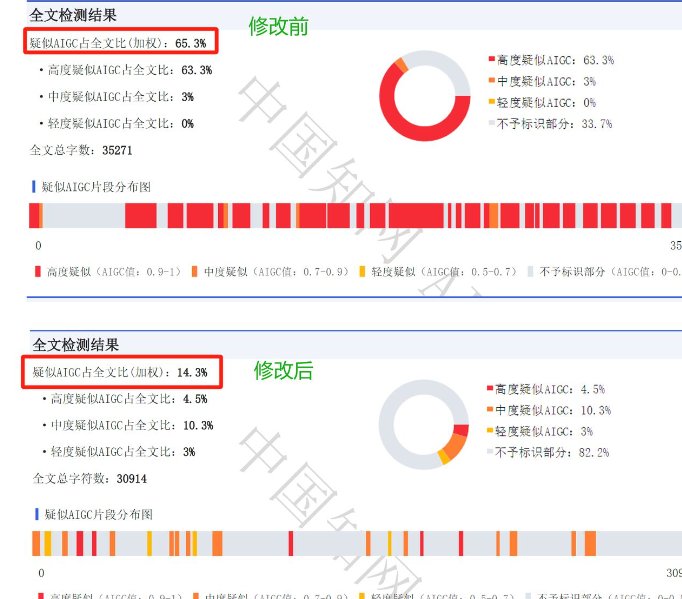
现在的查重工具早就不是单纯比对文字重复了。Turnitin、知网这些主流系统,去年就推出了专门的 AI 检测模块。它们用海量的 AI 生成文本训练出识别模型,能捕捉到人类几乎察觉不到的机器特征。
检测维度也在不断升级。除了词频、句式,现在还会分析 “语义熵值”—— 简单说就是文本的信息量波动。人类写作时,一会儿讲细节一会儿谈宏观,熵值忽高忽低;AI 写的文章熵值变化很平缓,就像一条波动很小的直线。这种数学特征,机器一算一个准。
更狠的是 “对抗性训练”。查重系统会先用 AI 生成大量文本,然后标记这些文本的特征,再反过来优化检测算法。就像病毒和疫苗的赛跑,AI 写作的新套路刚出现,查重系统的识别方法就跟着更新了。现在甚至能检测出经过 “人工修改” 的 AI 文本 —— 只要核心逻辑和语言模式没改,照样能认出来。
想让 AI 写的文章躲过查重,光改几个词换几个句子没用。得从根本上打破它的写作惯性 —— 多加入个人经历、独特观点,甚至故意留一些 “不完美” 的表达。毕竟,真正的原创从来不是完美的,而是带着体温和个性的。下次用 AI 写东西,记得多问问自己:这话说的像 “我” 吗?还是更像一个没感情的打字机?
【该文章由diwuai.com
第五 ai 创作,第五 AI - 高质量公众号、头条号等自媒体文章创作平台 | 降 AI 味 + AI 检测 + 全网热搜爆文库🔗立即免费注册 开始体验工具箱 - 朱雀 AI 味降低到 0%- 降 AI 去 AI 味】