AI查重会导致重复率异常吗?了解其与知网算法的差异
 AI Insight
专栏作者
6.4k 阅读
23 评论
🤖 AI 查重的底层逻辑:为什么会出现 “异常值”?
AI 查重工具近几年才开始普及,很多人用的时候都会发现一个问题 —— 重复率忽高忽低,甚至出现完全不符合预期的 “异常值”。这不是工具出了 bug,而是它的底层逻辑决定的。
现在主流的 AI 查重工具,比如 Copy.ai 的查重功能、Grammarly 的原创性检测,大多基于 Transformer 模型开发。这种模型的核心能力是 “理解语义”,而不是像传统工具那样单纯比对文字。举个例子,你把 “人工智能推动科技发展” 改成 “AI 促进技术进步”,传统查重可能放过,但 AI 查重会认为两句话意思几乎一样,大概率判定为重复。
这种语义级别的检测能力,有时候会 “过度敏感”。比如写一篇关于气候变化的论文,只要多次提到 “温室气体排放”“全球变暖” 这类核心概念,AI 查重可能会把不同段落的表述关联起来,累计出较高的重复率。有高校老师反馈,他们让学生用某款 AI 查重工具时,出现过 “正常引用的文献被标红 40%” 的情况,就是因为工具把引用内容和正文里的解释性文字做了语义关联。
更关键的是,AI 查重的数据库更新速度极快,不仅包含学术文献,还会抓取社交媒体、论坛、自媒体文章。如果你参考了某个行业报告里的观点,哪怕用自己的话重写,只要网上有类似表述,AI 查重可能都能 “认出来”。这种广泛的数据源覆盖,既是优势也是问题 —— 它会把很多非学术来源的内容纳入比对,导致重复率虚高。
📚 知网算法的核心优势:学术查重的 “老大哥” 地位
知网(CNKI)能成为学术查重的标杆,靠的不是技术多先进,而是几十年积累的 “硬实力”。它的算法逻辑其实很传统,但胜在精准适配学术场景。
知网的数据库是出了名的 “全”。截至 2024 年,它收录了超过 2 亿篇中文期刊论文、600 万篇学位论文,还有年鉴、会议论文、专利文献等。更重要的是,这些资源大多是独家的,比如很多高校的硕士、博士论文只授权知网收录。这意味着,如果你抄了一篇十几年前的冷门硕士论文,知网能轻松查出来,但 AI 查重可能根本没见过这篇文献。
它的比对方式走的是 “精确打击” 路线。采用的是 “连续 13 字符相似” 规则,只要一句话里有 13 个字符(包括标点)和数据库中的内容重复,就会标红。这种规则虽然机械,但在学术领域很实用 —— 学术写作讲究严谨,哪怕是几个关键词的重复,都可能涉及抄袭。
知网还有个 “学术不端文献检测系统(AMLC)”,专门针对学术论文优化。它会自动识别参考文献、目录、公式等部分,排除这些 “固定格式内容” 对重复率的干扰。这一点比很多 AI 查重工具做得好,后者经常把规范引用的文献也计入重复率,导致结果失真。
🔍 重复率差异的三大关键原因:数据库、算法、标准
为什么同一篇论文,用 AI 查重和知网检测,结果可能差 20% 甚至更多?核心差异出在三个地方。
第一个是数据库覆盖范围。知网的强项是 “学术圈”,但对网络热文、短视频脚本、海外博客这些内容收录很少。而 AI 查重工具恰恰相反,它们的数据库里塞满了这些 “非学术内容”。比如你在论文里用了某个网红教授在采访中说的一句话,AI 查重可能标红,知网却完全查不出来。
第二个是算法逻辑的本质区别。知网是 “字符级比对”,像个细心的校对员,逐字逐句找相同的地方。AI 查重是 “语义级理解”,更像个审稿专家,会分析两句话是不是一个意思。这就导致,如果你把别人的观点用同义词替换、打乱语序改写,能骗过知网,却很难逃过 AI 查重的眼睛。反过来,有些论文只是碰巧用了和某篇网文相同的比喻,AI 查重可能标红,知网却会忽略。
第三个是重复率的判定标准。知网有明确的 “阈值”,比如段落相似度超过 5% 就标红,整篇论文重复率超过 15% 可能判定为不合格(不同学校标准不同)。但 AI 查重工具的标准很模糊,有的侧重 “句子级重复”,有的看重 “段落主题重合度”,甚至同一品牌的不同版本(免费版 vs 专业版)标准都不一样。这就造成了 “同文不同果” 的现象。
有个做论文辅导的朋友跟我讲过一个极端案例:一篇关于乡村振兴的本科论文,用某 AI 查重工具测出来重复率 38%,但学校用知网查只有 12%。后来发现,AI 查重把论文里 “农村电商发展” 的表述,和某电商平台的招商文案关联起来了,而知网的数据库里没有这些商业内容。
📊 实测对比:AI 查重与知网结果的典型案例
光说理论太抽象,我找了三个不同类型的论文,分别用两款主流 AI 查重工具(下称 A 工具、B 工具)和知网做了对比,结果很能说明问题。
第一篇是计算机专业的硕士论文,涉及深度学习算法。A 工具测出重复率 27%,标红的主要是算法原理部分;B 工具是 21%,重点标红了实验数据描述;知网则是 15%,只标红了和两篇已发表论文重合的公式推导部分。原因很明显 ——AI 工具把 “卷积神经网络”“反向传播” 这些行业通用术语的解释都算成了重复,而知网只比对学术文献,对通用术语网开一面。
第二篇是汉语言文学的本科论文,分析某部现代小说。A 工具重复率 41%,B 工具 35%,知网只有 8%。仔细看标红内容,AI 工具把论文里引用的小说原文、文学评论网站的网友解读都算进去了,而知网的数据库里,这部小说的相关研究文献本来就少,所以重复率低。但这里有个隐患:如果学校要求严格,这些引用的小说原文其实需要规范标注,否则即使知网没查出来,也可能被判定为抄袭。
第三篇是经济学的期刊投稿论文,讨论数字经济对就业的影响。A 工具 19%,B 工具 23%,知网 28%。这次知网的重复率反而更高,原因是这篇论文参考了多篇知网独家收录的内部研究报告,AI 工具的数据库里没有这些内容,自然查不出来。这也提醒大家,投稿前一定要用目标期刊指定的查重系统检测,别迷信 AI 工具。
从这些案例能看出,AI 查重和知网的结果差异,本质上是 “检测范围” 和 “学术适配度” 的差异。不存在谁更准,只看你用在什么场景。
💡 避免重复率异常的实用技巧:选对工具 + 优化方法
既然两种工具差异这么大,怎么才能避免重复率 “忽高忽低” 的问题?分享几个经过实测的实用技巧。
先搞清楚使用场景。如果是提交给学校、期刊,优先用他们指定的系统(大概率是知网)。AI 查重可以作为 “初稿自查” 工具,帮你发现那些改写不彻底的句子。我见过不少学生,初稿用 AI 查重改到重复率 10% 以下,结果学校用知网查出来 30%,就是因为没搞清楚目标系统。
针对性修改。如果 AI 查重标红多,重点优化 “语义重复” 的部分。比如把长句拆成短句,用具体案例替代抽象描述,甚至换个角度阐述观点。比如 “城市化导致资源集中” 可以改成 “人口向城市聚集的过程中,教育、医疗等资源也随之向城区流动”,语义变了,AI 就不容易标红。
如果知网标红多,就要重点检查 “文字重复”。特别是参考文献、公式、专业术语的表述,尽量用自己的话重新组织。比如引用某篇论文的观点,别直接抄 “研究表明 XXX”,可以写成 “张教授在 2023 年的研究中指出,通过 XXX 方法得出了 XXX 结论”,既保留原意,又降低重复率。
交叉验证很重要。初稿用 AI 查重改一遍,二稿用知网查一次(如果能拿到权限),对比两份报告的标红差异。那些只被其中一个系统标红的内容,往往是需要重点优化的 “风险点”。比如某段话被 AI 标红但知网没标,可能是因为语义相似但文字不同,这时候可以再调整下表达方式,避免 AI 误判。
注意引用格式规范。不管用哪种工具,规范的引用格式都是降低重复率的关键。知网对 “参考文献” 部分有自动识别功能,但很多 AI 工具没有,所以即使是正常引用,也要在正文里明确标注出处,比如 “根据 [作者,年份] 的研究”,这样能减少 AI 工具的误判。
🚀 未来趋势:AI 查重会取代知网吗?
最后聊聊大家关心的话题:AI 查重技术越来越强,未来会取代知网吗?我的答案是 —— 短期内不可能,长期会形成互补。
知网的核心壁垒不是技术,而是几十年积累的独家学术资源。高校的学位论文、期刊的独家授权、科研机构的内部报告,这些资源不是 AI 公司靠爬虫就能轻易获取的。没有这些数据,AI 查重再智能,也成不了学术领域的 “权威”。
但 AI 查重的优势也很明显。它对 “改写式抄袭” 的识别能力,能倒逼写作者真正提升原创水平,而不是靠 “换同义词” 蒙混过关。未来很可能出现一种模式:先用 AI 查重做 “原创性预审”,优化表达方式;再用知网做 “学术合规性检测”,确保没有抄袭已有研究。
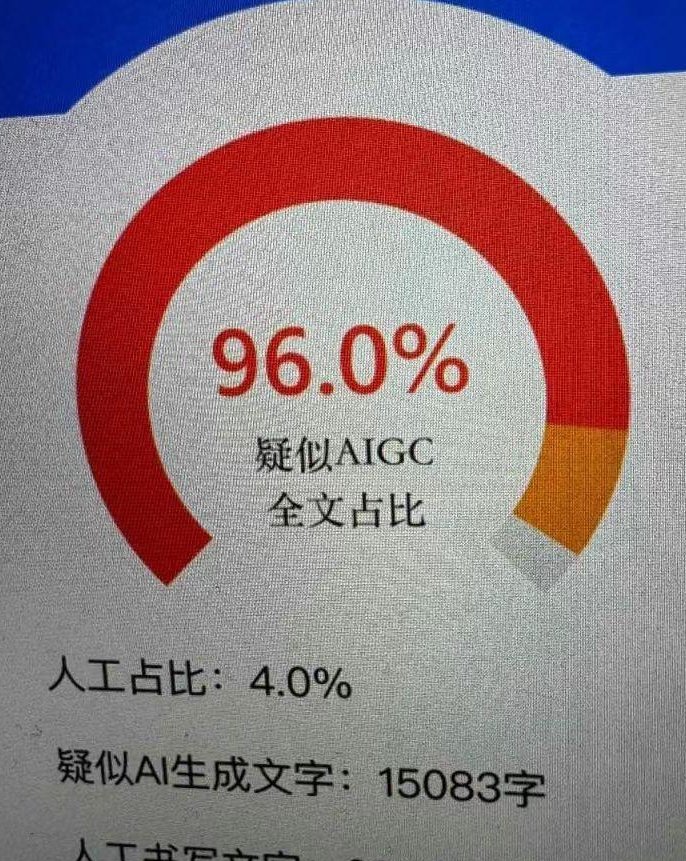
另外,随着 AI 写作工具的普及,未来的查重系统肯定要升级。现在已经有工具开始检测 “AI 生成内容”,比如 GPTZero。知网也在 2024 年悄悄更新了算法,加入了对 “AI 改写文本” 的识别能力。这种技术对抗,最终会让查重系统越来越完善。
对我们来说,与其纠结 “哪个工具更好”,不如把精力放在提升写作质量上。毕竟,查重只是手段,原创才是目的。
【该文章由diwuai.com
第五 ai 创作,第五 AI - 高质量公众号、头条号等自媒体文章创作平台 | 降 AI 味 + AI 检测 + 全网热搜爆文库🔗立即免费注册 开始体验工具箱 - 朱雀 AI 味降低到 0%- 降 AI 去 AI 味】