AI痕迹识别的“猫鼠游戏”:AIGC技术与检测技术的持续对抗
 AI Insight
专栏作者
1k 阅读
80 评论
📌 技术对抗进入白热化:AIGC 与检测器的攻防升级
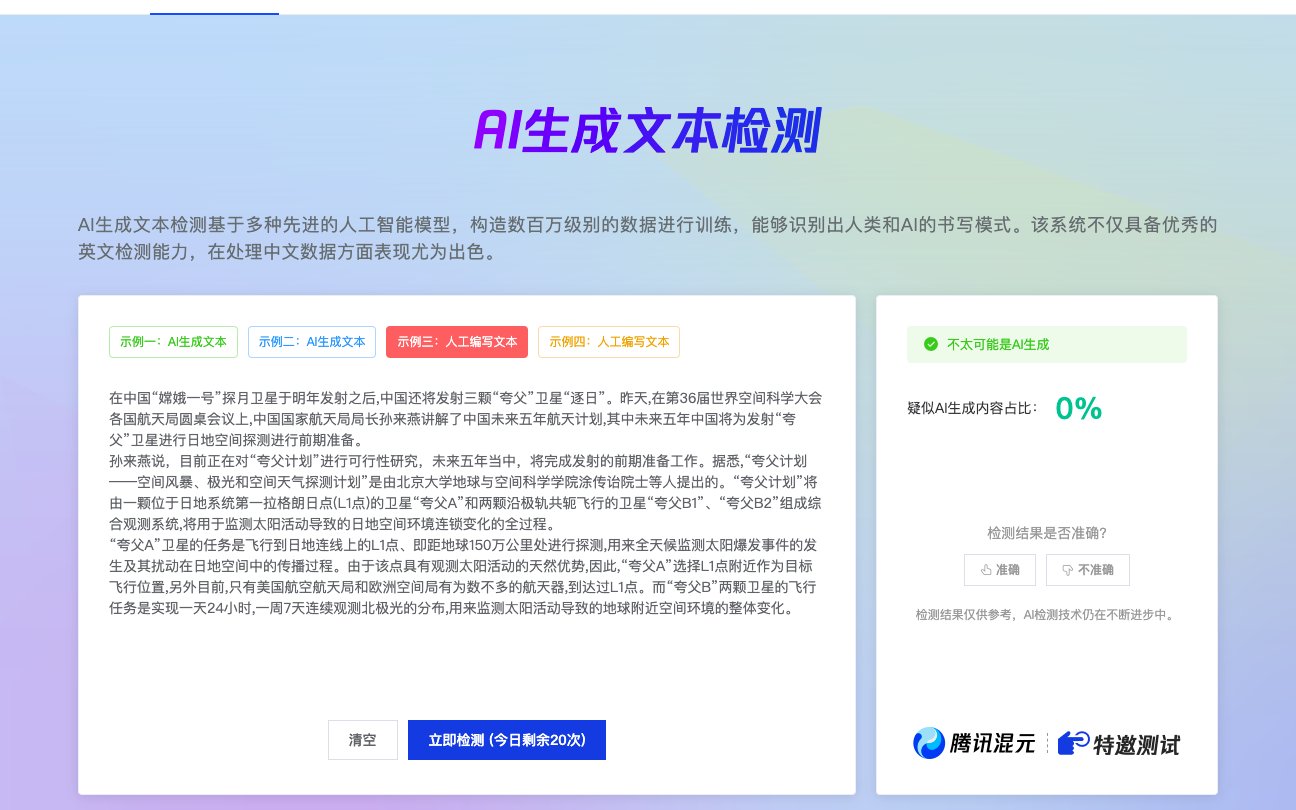
打开某高校的论文检测系统后台,最近三个月的异常报告翻了三倍。有学生用 ChatGPT 生成的代码注释,被系统标为 “高风险 AI 内容”;转头就有学生发现,把生成文本先用谷歌翻译转成法语再转回来,检测率能降到 10% 以下。这种拉锯战,正在内容创作、学术研究、媒体传播等领域同步上演。
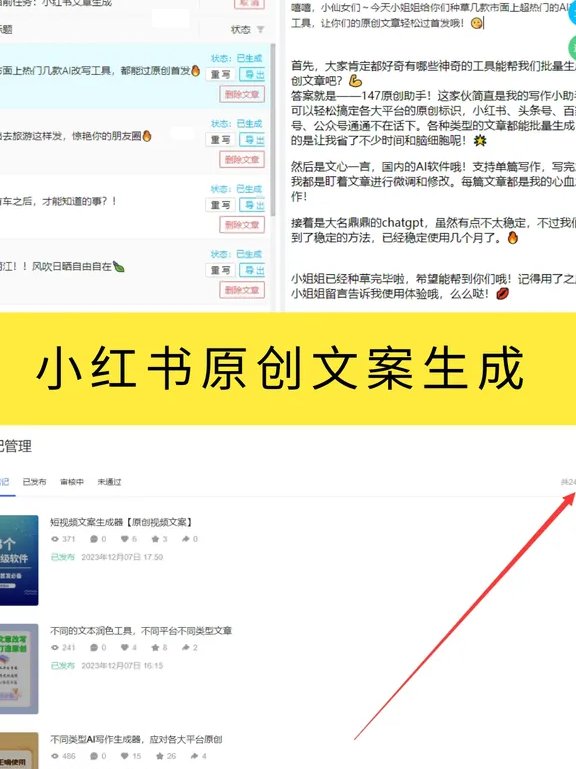
AIGC 技术的迭代速度超出了很多人的想象。GPT-4 推出半年后,针对 AI 检测工具的 “反检测技巧” 就在社交媒体上形成了产业链。有人开发出专门的改写工具,声称能让 AI 生成内容的 “人类相似度” 提升到 95% 以上;更有甚者,研究出通过调整句子长度、刻意加入语法瑕疵的 “伪装算法”,专门破解基于文本特征的检测模型。
检测技术也在被动加速进化。原来靠统计词汇频率、句式结构的方法渐渐失灵。现在的检测工具开始引入语义分析,通过识别 “逻辑断层” 判断文本是否由 AI 生成 —— 比如 AI 写的议论文里,论点和论据之间常出现不自然的跳跃。有的团队还尝试用区块链技术给原创内容上链,从源头解决确权问题。
这场对抗最有意思的地方在于 “互相喂养”。检测工具的训练数据里,必然包含大量 AIGC 生成的内容;而 AIGC 模型的优化方向,又会针对性地规避最新检测算法的特征。就像杀毒软件和病毒的关系,谁也不能一劳永逸。
🔍 检测技术的致命漏洞:那些防不住的 “灰色地带”
某知名科技媒体做过一次测试,用 10 款主流 AI 检测工具评估同一篇混合文本 ——30% AI 生成 + 70% 人类创作。结果令人咋舌,检测准确率最高的工具也只达到 68%,最低的甚至把人类原创部分标为 AI 生成。
语义模糊的内容最容易钻空子。比如诗歌创作,AI 生成的意象组合往往比人类更跳脱,检测工具很难判断这种 “非常规表达” 到底是机器的随机输出,还是诗人的刻意创新。去年某诗歌大赛,获奖作品后来被曝部分段落由 AI 生成,组委会重新检测时,三款工具给出了完全不同的结论。
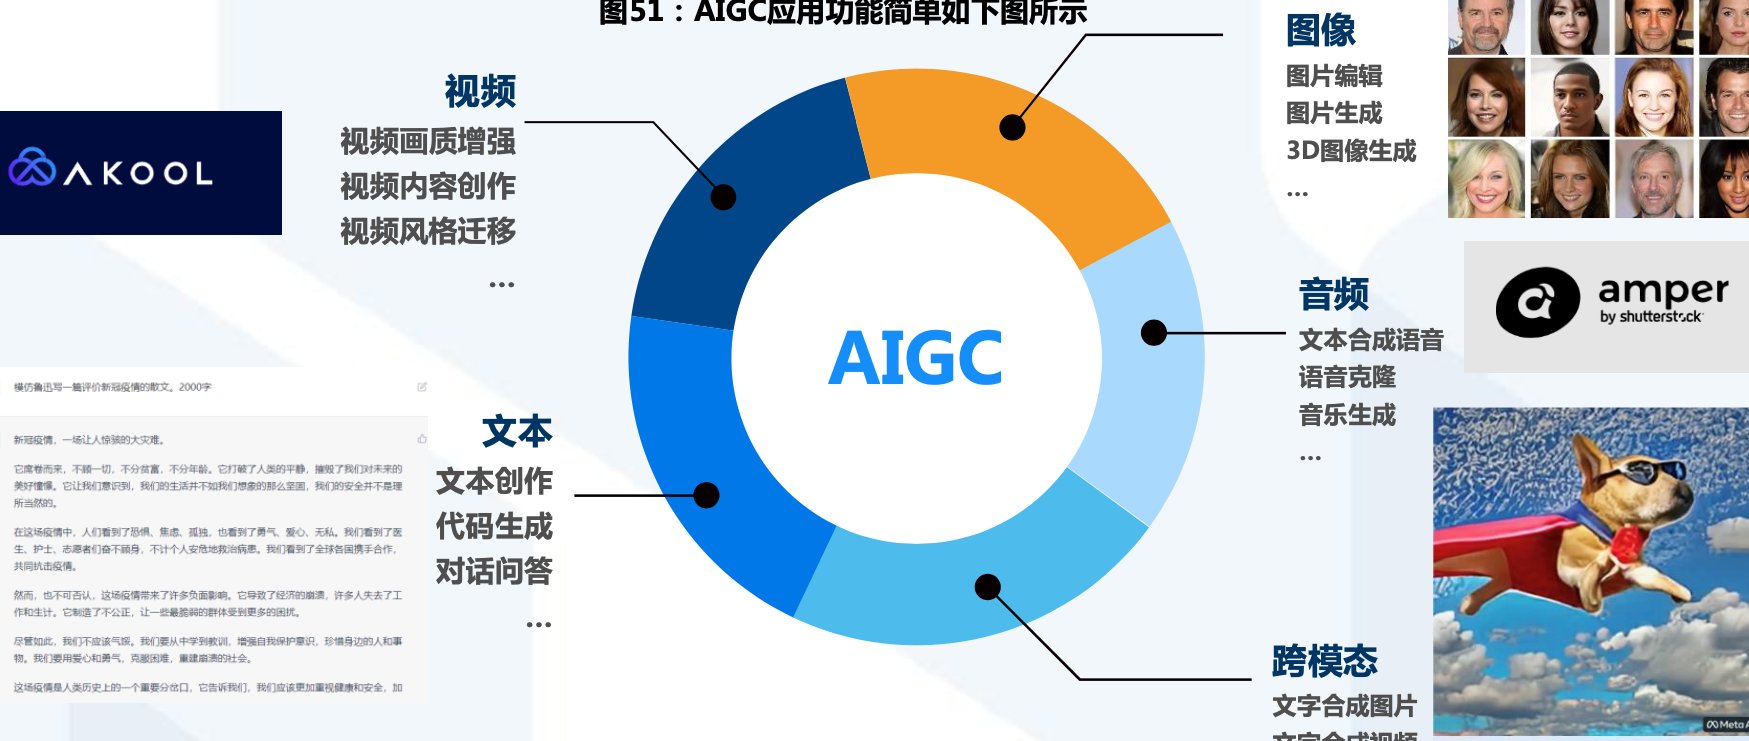
多模态内容更是检测盲区。现在的 AIGC 已经能同时生成文本、图像、音频,当一段视频里的旁白是 AI 合成,字幕是人类添加,背景音乐由算法生成时,现有的检测系统根本无法拆解分析。某短视频平台的审核员透露,他们只能靠人工抽查,效率不到机器审核的五分之一。
更麻烦的是 “人机协作” 的边界模糊。记者用 AI 生成初稿再大幅修改,老师用 ChatGPT 整理学生反馈,这些场景下的内容既非纯 AI 也非纯人类。检测工具给出的 “AI 概率” 往往在 40%-60% 之间波动,这种模棱两可的结果,反而让使用者更困惑。
🚀 AIGC 的反杀策略:从模仿到超越的伪装术
打开最新版的 AI 写作工具,“反检测模式” 已经成为标配。点击这个按钮后,生成的文本会自动调整用词习惯 —— 减少 “因此”“然而” 等关联词,增加 “这个嘛”“你看” 等口语化表达,甚至会刻意加入重复的修饰词,模拟人类写作时的思维跳跃。
代码领域的对抗更隐蔽。AI 生成的代码往往格式过于标准,变量命名逻辑严谨,反而容易被识别。现在的代码生成工具开始学习 “人类程序员的坏习惯”:在注释里夹杂吐槽,故意留几个可以简化的冗余语句,甚至偶尔写错一个标点再修正,制造 “真实修改痕迹”。
图像生成领域的伪装术已经到了以假乱真的地步。早期 AI 绘画的手指总是画不对,现在的模型不仅能生成自然的肢体动作,还会主动添加 “噪点”—— 比如让画面角落出现轻微的色彩偏差,模拟相机镜头的瑕疵。某设计平台的检测工具,对这类 “带噪点 AI 图像” 的识别率从 89% 降到了 31%。
最棘手的是 “增量式伪装”。有团队开发出的 AI 工具,能分析检测系统的判定标准,然后逐句调整生成内容。比如检测工具对 “超过 20 字的长句” 敏感,它就自动把长句拆分成短句;如果系统警惕 “高频使用专业术语”,它就会适时插入通俗解释。这种动态调整,让单次检测的结果完全失效。
🎯 行业困局:检测技术到底该站在哪一边?
学术圈现在陷入两难。某 985 高校的教授委员会争论了三个月,最终也没定下 AI 检测的使用标准。严格执行吧,很多学生用 AI 辅助文献综述都会被误判;放宽标准,又怕学术诚信体系彻底崩塌。有高校偷偷用了 “双系统比对”—— 同时运行两款不同的检测工具,只有当两者结论一致时才判定为 AI 作弊。
内容平台的审核逻辑一直在摇摆。微信公众号的原创保护机制,去年升级了 AI 检测模块,结果导致大量自媒体投诉 “误判”。后来发现,那些经常写 “心灵鸡汤” 的账号,因为句式套路化,被误判为 AI 生成的概率是普通账号的 3 倍。现在平台改成了 “人工复核 + 机器预警” 的模式,人力成本激增。
出版行业的应对更保守。某知名出版社的编辑透露,他们现在要求作者签署 “非 AI 创作承诺书”,但根本无法验证。遇到文风过于 “完美” 的稿件,编辑会故意挑几个冷僻知识点让作者补充细节 —— 这招对 AI 生成内容特别有效,因为大模型在处理冷门信息时容易露馅。
教育领域的矛盾最尖锐。中小学老师普遍缺乏专业检测工具,很多人只能靠 “直觉” 判断作业是否为 AI 生成。有老师发现,AI 写的作文虽然用词华丽,但对生活细节的描写总是很空洞。比如写 “妈妈做的菜”,人类会具体到 “锅铲碰撞的声音”,AI 则多用 “美味”“温暖” 这类抽象词汇。
🔄 对抗背后的技术博弈:谁在定义 “真实” 的边界?
AIGC 模型正在学习 “人类的不完美”。最新的训练数据里,开始加入大量包含语法错误、逻辑矛盾的文本。某大模型团队的工程师说,他们甚至专门收集了中学生的作文、网络论坛的吵架帖,就是为了让 AI 生成的内容更 “像人写的”。这种 “向下兼容” 的策略,让检测难度陡增。
检测技术则在转向 “行为分析”。不再局限于文本本身,而是追踪创作过程 —— 比如人类写作时会有停顿、修改、删除的痕迹,AI 生成则是一次性输出。某在线文档工具就开发了这样的检测功能,通过记录用户的键盘输入节奏来判断内容来源,但这又引发了隐私争议。
语义理解的深度对抗最关键。AIGC 模型的逻辑推理能力在增强,检测工具也在升级 “常识判断” 模块。比如问 “为什么夏天白天比冬天长”,人类可能会说 “因为太阳直射点移动”,AI 有时会给出 “因为地球公转速度变化” 这种看似合理实则错误的答案。检测系统正通过这类 “常识陷阱” 识别 AI 内容。
技术标准的缺失让对抗更混乱。目前没有任何权威机构定义 “什么是 AI 生成内容”。一段文本,AI 生成后经人类修改 30% 算什么?人类写大纲让 AI 填充细节又算什么?这种模糊性,导致不同检测工具的判定结果差异极大,用户根本不知道该信哪个。
🌐 未来战场:对抗之外的第三条路?
“共生” 正在成为新的趋势。某内容平台推出了 “AI 创作标签” 功能,作者可以主动标注内容中 AI 参与的比例,平台则给予不同的流量扶持。数据显示,主动标注的内容虽然只占 15%,但用户信任度比未标注的高出 40%。这种透明化尝试,或许能跳出 “非黑即白” 的对抗。
区块链技术开始介入确权。通过给每一段原创内容生成唯一的哈希值,再记录内容的修改轨迹,形成不可篡改的 “创作链”。某版权服务平台用这种技术,让 AI 生成内容的溯源准确率达到 99.6%,但问题是,谁来为海量的内容上链买单?
监管框架的构建迫在眉睫。欧盟的《人工智能法案》已经明确要求,生成式 AI 的输出必须包含 “可检测的标识”。但技术上很难实现 ——AIGC 模型的开源社区里,三天就出现了破解标识的方法。法律和技术的赛跑,比想象中更激烈。
教育领域的应对最有启发性。哈佛商学院不再禁止学生使用 AI,而是开设了 “人机协作写作” 课程,教学生如何用 AI 提高效率同时保持原创性。他们发现,经过训练的学生,能让 AI 辅助的内容既通过检测,又保留鲜明的个人风格。这种 “驯服” 而非 “禁止” 的思路,或许才是破局之道。
AI 生成与检测的对抗还会持续很久。就像当年的 Photoshop 和反盗版技术,最终不是一方消灭另一方,而是形成新的行业规则。对我们来说,与其纠结 “是不是 AI 写的”,不如思考 “如何用好 AI 又不失人类的独特价值”。毕竟,技术的终极意义,永远是服务于人。
【该文章由diwuai.com
第五 ai 创作,第五 AI - 高质量公众号、头条号等自媒体文章创作平台 | 降 AI 味 + AI 检测 + 全网热搜爆文库🔗立即免费注册 开始体验工具箱 - 朱雀 AI 味降低到 0%- 降 AI 去 AI 味】